配对设计资料统计分析公益课
配对设计资料如何统计分析【30天学会医学统计学公益课(D5)】
摘要
2026年8月5日,医学论文与统计分析公众号发布公益课程,讲解配对设计资料的统计分析方法。课程为30天学会医学统计学系列第5天内容,面向医学科研人员,提供配对设计数据的处理技巧。
AI 主编 · 推荐理由推荐理由
对药企研发人员有参考价值,但非监管动态,建议作为学习资源,不进入精选池。
五维评分
正文
朋友们,“30天学会统计学"公益课上线了!全面指导统计学学习,以及SPSS与郑老师风暴统计平台两种较流行的统计学软件!
本课程是浙江中医药大学医学统计学教研室的公益、免费公开视频课!不是骗人入坑收费的广告。本课程公益网络视频课定期开课,欢迎您参与学习。
您不妨点击了解详情
Day 5: 配对设计资料的统计分析
本日学习任务
1. 微信群内视频1段“配对t检验”(16分钟)
2. 公众号推文1篇:D5
3. 微信群内测试题
以下文字版教程,今后可能会失效,如需获得全套视频课程,以及永久版的文字版教程,请加入公益免费课程群(发送“报名”到公众号),全面学习医学统计学与SPSS应用
实验性研究常见包括完全随机设计和配对(配伍)设计两种实现均衡可比的设计方法。
之前的课程介绍的t检验、秩和检验都是基于完全随机设计资料开展的统计分析,本日介绍配对设计的数据分析。
配对设计
配对设计是将受试对象配成对子,随机给予每对中的两个体以不同处理。配对条件为主要的非处理因素。
在动物试验中,常将种属、性别、年龄、体重相近的两动物配成对子;临床试验中,常将性别相同,年龄,生活条件、病情轻重等相似的两个病人配成对子。
配对设计常见有两种形式:
自身前后配对:同一对象自身前后数据进行比较分析,比如干预前后血糖值比较;
平行配对随机化:同一一对象随机接受两种处理,如同一标本用两种方法进行检验同一患者接受两种处理方法;将条件相近的实验对象配对,并分别随机给予两种处理。
常见配对设计形式包括:
-同一受试对象处理前后的数据(自身前后)
-同一受试对象两个部位的数据(自身平行)
-同一样品用两种方法(仪器等)检验的结果(自身平行)
-配对两个受试对象分别接受两种处理后的数据(异体配对)
配对设计的优点(自身前后配对除外)是它可以保证非常好的可比性,而均衡可比的各处理组比进行比较分析,探讨干预措施与结局的因果关系,结论更可靠。
配对设计与完全随机设计
这里比较下完全随机设计和配对设计的差别。
实验性研究把人至少分成两组,比如100名实验对象。对于完全随机设计,就是100个人通过抽签抓阄的方式随机分为两组,这两组样本量都可以不一样;对于配对设计,在100人跳出相似的个体,凑成对子,可能100个人能凑相似的对子的只有40对,然后40对个体分成2组,每组各40名,剩下的20名对象就不要了。
大家可以看出来,完全随机设计操作更简单,样本如容易获取;配对设计对子不好凑,但是凑出来的对子可比性很强,因为一个对子的两个个体特征都差不多。
另外必须要提另外一组概念:成组设计和配对设计。这组概念代表着另外一组名称:独立、非独立。成组设计意味着独立,配对设计意味着非独立、
完全随机设计属于成组设计的一种(成组设计还包括自然成组,比如男性和女性的虹升高比较,是独立成组的两组比较)。完全随机设意味着是数据独立,形成2组个体数据相互独立,一组数据不会影响另外一组数据,而配对设计两组数据则往往不独立,存在着相关性。为啥相关?大家可以联想下双胞胎,双胞胎的行为、生理生化、健康结局可能相似的,如果40对双胞胎分到两组,那么两组数据是不是就相关了?
实例分析
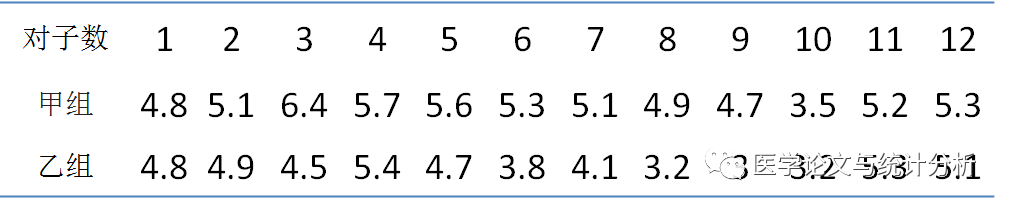
某项研究评估咖啡因对人体心肌血流量的影响,将24名年龄、BMI、专业相似的男性大学生配成12对,每组的两个成员随机分配到咖啡干预组、空白对照组,两组成员实验后测定心肌血流量[ml/(min·g)],问干预后心肌血流量有无差异。数据库见d5_kafei.sav。
思考
这个案例需要思考:
-该研究属于何种类型的研究设计
-如果是匹配设计,是配伍还是配对?
-结局变量属于什么类型的变量?
-正态性问题如何考虑?
案情分析
对于本案例,初学者往往有两种不分青红皂白的直觉:第一种,既然分为两组,那么属于成组两样本的研究,可能采用两样本t检验;第二种,两组样本量一样,若数据形成本案例类似的表格形式,肯定是配对设计。
直觉害死人!到底是成组两样本还是配对设计,一定要看研究者的文字说明,如果配对设计,必然有相应配置成对、成伍的意思。
本例资料属于异体配对,其结局心肌血流量为定量数据,因此若要探讨干预组和对照组心肌血流量有无差异,虽然是定量数据,则不能考虑两样本t检验,这是因为干预组和对照组两组数据不再符合两样本t检验三个重要条件“正态性、独立性、方差齐性”中的独立性。
配对设计产生的两组数据是相关的。可以发现,大致上干预组血流量变量值越高,则对照组变量值也会高于其它运动员。比如运动员第4对,干预组变量值为5.7,而对照组为5.4;相反,运动员第10对,干预组变量值为3.5,而对照组为3.2。这一现象表明两组数据存在不符合独立性的条件。此时,不宜采用DAY 3 介绍的成组两样本t检验进行分析。
统计分析策略
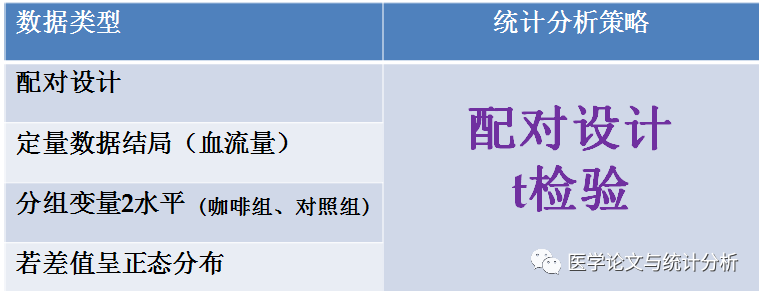
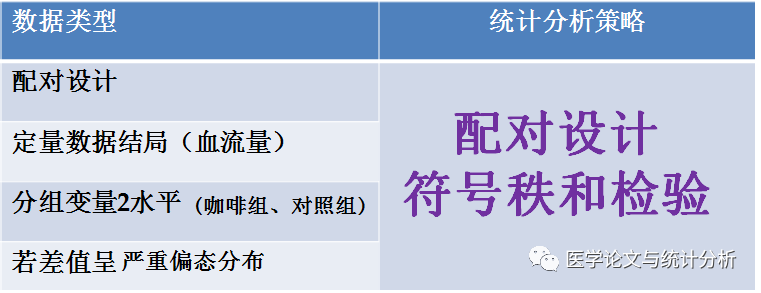
对于本例,则要考虑两种新的统计学方法:配对t检验或者符号秩和检验。配对t检验和符号秩和检验两种方法的选择,关键在于数据“正态性”的问题。这里的“正态性”不是两组数据的正态性”,是两组数据差值的正态性”。本例中,差值即12对运动员干预组、空白对照血流量的差值。
若差值为正态或者近似正态分布,则采用配对t检验;若差值为严重偏态分布,则采用Wilcoxon符合秩和检验(本方法出自统计学家Wilcoxon之手)。
总结来说,
或者
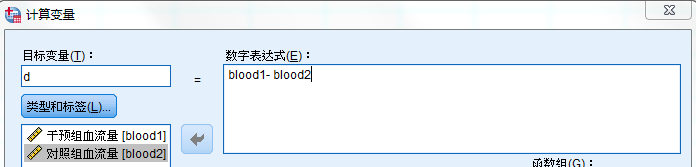
差值的计算与正态性检验
正态性检验结果:
结果如下,差值d夏皮洛-威尔克(SW)正态性检验显示,P=0.080,还不能认为数据是严重偏态分布的,因此,本案例的两组比较可以采用配对t检验进行统计分析。
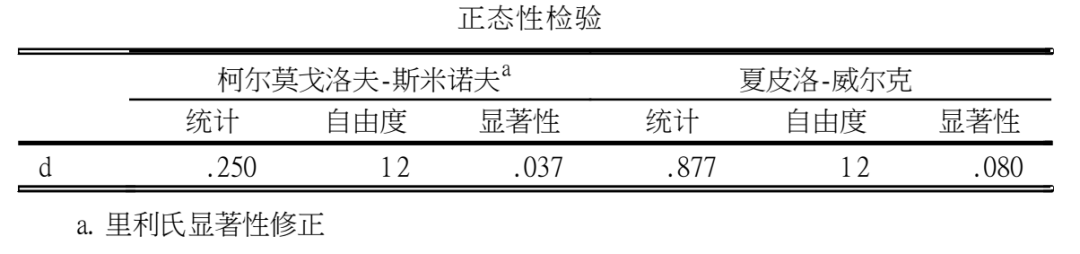
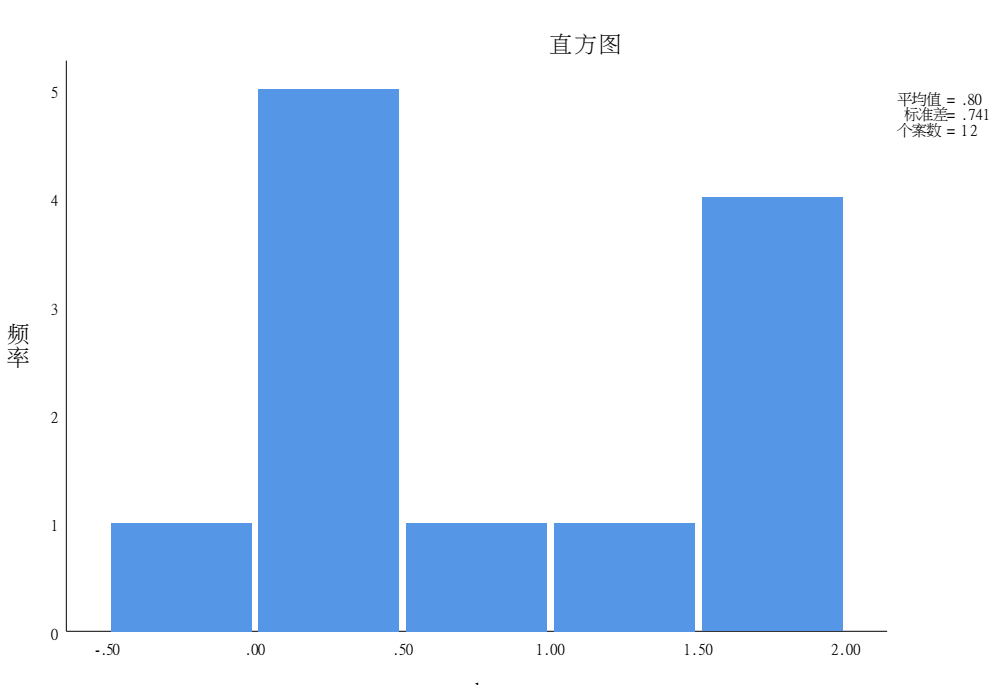
有人问郑老师,这数据不是正态分布吧。是的,这数据不是正态分布,但也不是偏态分布,可以认为近似对称分布,用配对检验没有问题。
如何利用SPSS进行配对t检验
本日软件操作的SPSS数据库是d5_kafei.sav,加入课程群即可获得。
配对t检验入口界面
分析-比较均值 -配对样本t检验
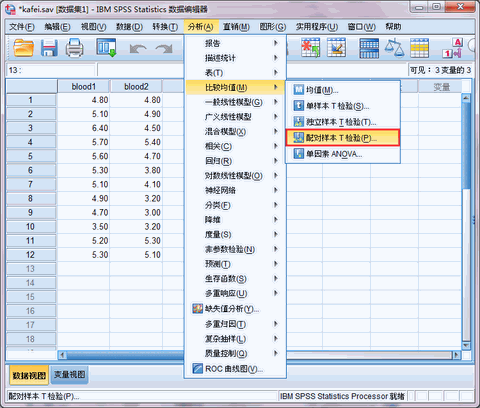
配对样本t检验对话框
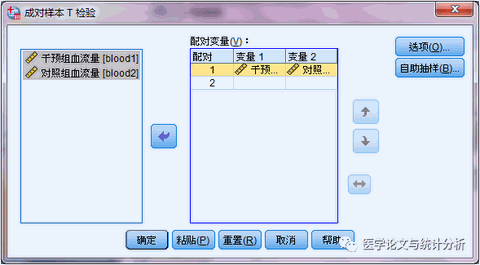
配对t检验操作非常简单,直接将左侧“干预组、对照组心肌血流量”同时选中,放到右边选框中即可。
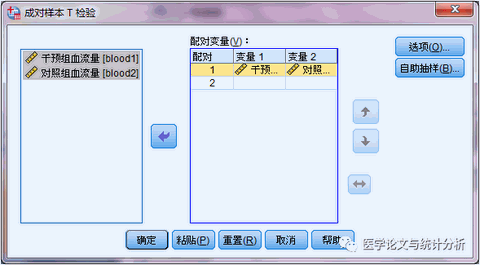
统计分析结果与解释
配对t检验结果有3张表。
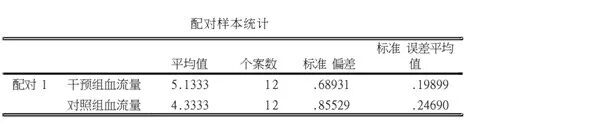
第1表:分组统计描述结果,干预组心肌血流量为5.13±0.69ml/(min·g),对照组心肌血流量为4.33±0.86ml/(min·g)
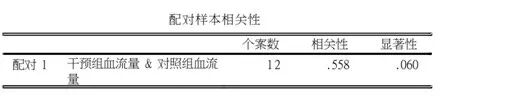
第2表为两组数据相关性的统计学检验。本表不重要,它描述了配对数据的相关性程度和P值,本例相关性系数为0.56(该值范围从0-1,越大相关性越强,0.56属于具有一定的相关性),P=0.060,表明还没有明显的证据能说明它们存在着统计学的相关(P值大于0.05,是因为样本量小)。在这里,P值不太有价值,关注相关系数即可。
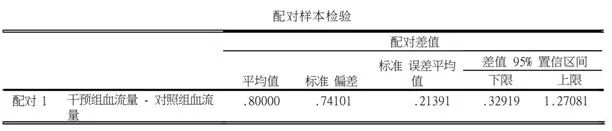
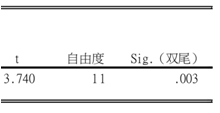
第3表为配对t检验的结果,如下表:配对差值为0.80(95%CI: 0.33-1.27);检验统计量t=3.740,P=0.003,配对差值与0值相比,差异具有统计学意义。
如何利用SPSS进行符号秩和检验
符号秩和检验入口界面
本文“心肌血流量”案例原则上应以配对t检验进行分析,但本文就本例也对符号秩和检验进行介绍,方便初学者学习和使用符合秩和检验。
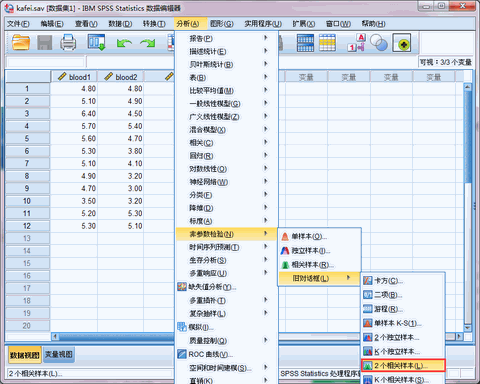
符号秩和检验对话框
配对秩和检验操作与配对t检验完全一致
秩和检验统计分析结果与解释
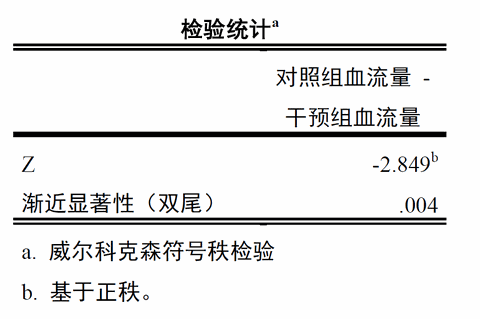
SPSS软件中,秩和检验一般默认采用正态近似法进行统计分析,它将计算检验统计量z值和p值,本题z=2.85(无需关注负号),P=0.004,配对差值中位数与0值相比,差异具有统计学意义。该结果与配对t检验相似,但这里主要探讨总体分布位置而不是总体均数。
结果及表格的规范表达
规范的统计表(其中一种形式)为:
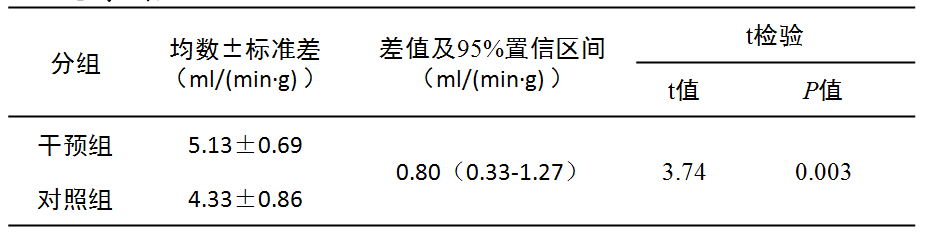
注:本例差值及95%CI在配对t检验结果中得到
风暴统计在线快速分析
“风暴统计”是郑老师团队基于R语言推出来的智能在线公益免费平台。(浏览器输入medsta.cn/software或者百度“风暴统计”)
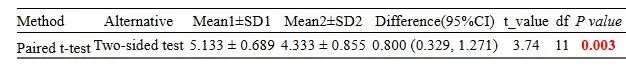
“风暴统计Zstats”来进行操作配对样本t检验和配对样本秩和,可通过菜单式的操作,快速得到两组的均差(IQR)、直接提供均差和95%CI,P值;同时可展示差值的正态性分析结果。
最终结果,一键生成word三线表,非常快捷,与SPSS结果一致
配对设计的注意事项
关于郑老师团队及公众号
全国较大的医学统计服务公众号平台,专注于医学生、医护工作者学术研究统计支持
郑老师团队2021年以来,开设了诸多医学科研与统计学课程,包括
统计入门课程、因果推断训练营、医学公共数据库平台与训练营等,有兴趣请点击链接了解下!