医医学论文与统计分析 · 公众号
7月21日 09:36 · 阅读约 7 分钟
医学论文与统计分析· 中国精选51分
INSPIRE数据处理平台上线,简化药械监管数据流程
INSPIRE数据处理平台上线!告别繁琐手工操作,几小时跑通全流程帮你省时省力
发布于 2026/7/21 09:36:03(北京时间)
摘要
2026年7月21日,中国医学论文与统计分析平台宣布INSPIRE数据处理平台正式上线。该平台旨在替代繁琐的手工操作,可在几小时内完成全流程数据处理,提升效率。适用于药械监管相关数据的处理与分析,具体功能包括数据整合、清洗、分析等。
AI 主编 · 推荐理由推荐理由
对药企注册和监管事务团队而言,数据处理效率直接影响申报进度。建议评估该平台是否兼容现有数据格式,并考虑试点应用以缩短数据准备周期。
正文
在医学公共数据库领域,许多数据库(MIMIC-III、INSPIRE、TCIA)为了保护患者的个人隐私,将数据的实际收集日期转换为“相对时间”。- 比如MIMIC-III将所有日期随机移至未来(2100-2200年),INSPIRE数据库则使用相对于首次入院的时间差。
出于伦理的角度,这种措施确实可以理解,但对各位想要入门数据库的研究者们来说,相对时间既不容易理解,也无法直接用于纵向数据分析,整理数据起来费时又容易混淆变量的时间先后顺序,造成完全错误的结果。今天我们以INSPIRE数据库为例,剖析如何解决“相对时间”使用困难的问题。在理解之后,相信各位也能触类旁通,在其他数据库中应用相似的思考逻辑。
INSPIRE 是韩国真实临床实践产生的围手术期纵向数据库,以"一次手术"为最小单位,约 13 万例手术记录,覆盖入院前、住院期间(入院、术中、术后、ICU)到出院后的全流程。它的数据能支撑起关联性研究、因果分析、机器学习预测等,价值极高。
INSPIRE 中所有检测指标、用药、生命体征、诊断数据都带有时间。但为了保护患者隐私,这些时间信息都不是真实日历日期,而是"距首次入院的分钟数"。- 例如,时间“1258”表示”距首次入院第 1258 分钟”。
在纵向数据研究中,时间先后顺序是进行因果关联推断的前提条件之一。我们已经习惯于处理“年/月/日/时/分/秒”这样的真实时间数据,而一旦处理像INSPIRE数据库这类相对时间,就要面临一系列难点:- 日期逻辑失效:看不到"几月几号",只能看到一串分钟数,不方便判断先后。
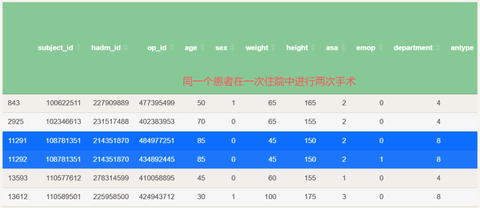
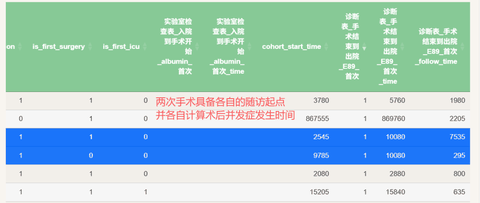
- 多次住院被"压平":一个患者若有两次住院,时间都从各自首次入院起算,两条时间线相互独立,需要自己理顺。
- 临床阶段无法直接判定:所谓"术前 / 术后 / 住院期间",都不能直接读出来,必须拿记录的时间去和每台手术的关键时间点逐一比较。
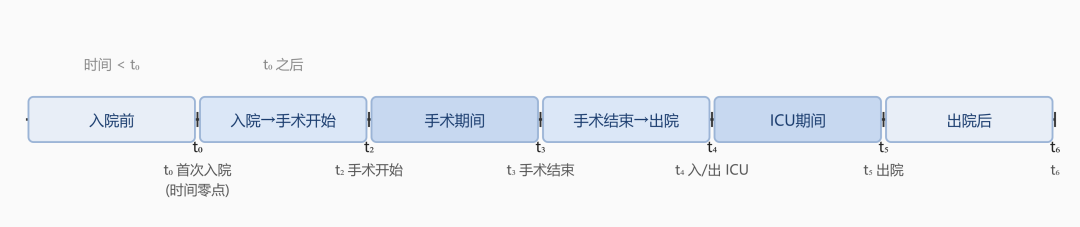
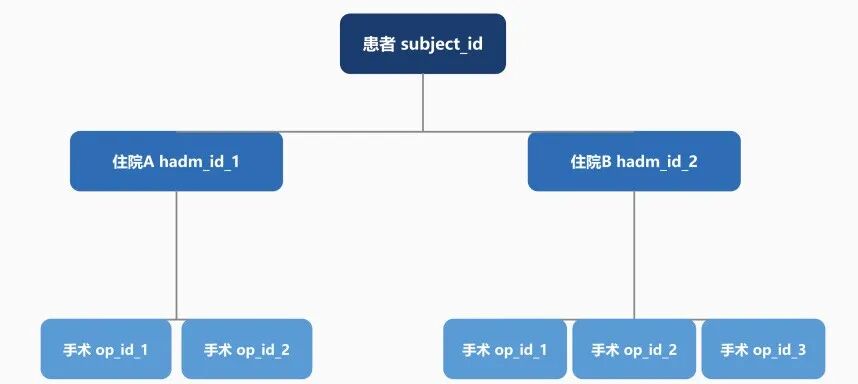
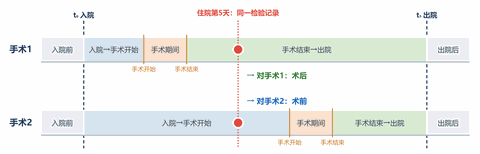
由于不是真实日期的数据,数据库里自带的各个相对时间节点就成了唯一的坐标。我们需要做的是构建一条符合临床实际情况的时间轴。当我们不再企图还原真实日期,而是把每台手术的相对时间轴,统一切成互不重叠的七个阶段。这条时间轴就像一把尺子,让我们得以度量纵向数据的时间顺序。接着,对每条记录,用它的时间字段与这台手术的关键时间点(入院、手术开始、手术结束、入 ICU、出 ICU、出院)逐次比较,判定它落在哪个阶段。这样,分钟数就被翻译成了可分析的阶段标签。然而,相对时间问题并不会这么简单就被解决。真实的临床实践中,每个患者可能多次住院,每次住院衍生出多次手术。检验、诊断、用药这类记录,只带"患者 + 住院 + 时间",并不知道"数据属于哪台手术"。于是同一行数据,可能被错误地和整个住院、甚至整个患者层面去合并,造成错位。- 一份"住院第 5 天"的检验结果,对第一台(第2天)手术而言是"术后",
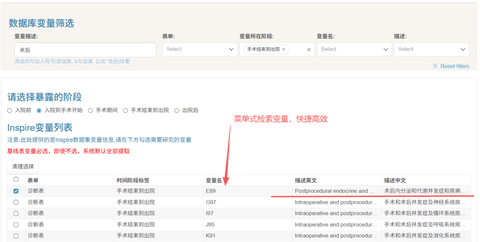
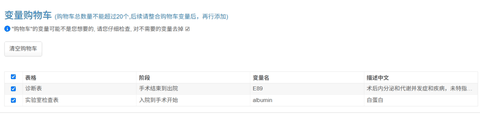
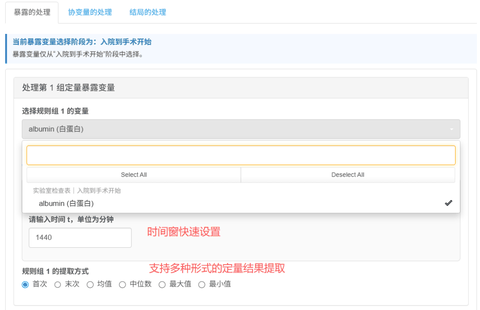
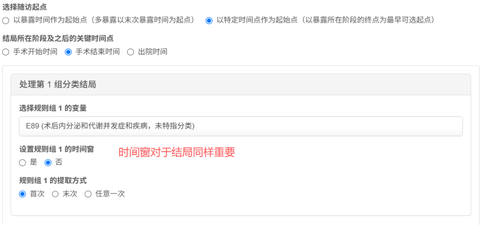
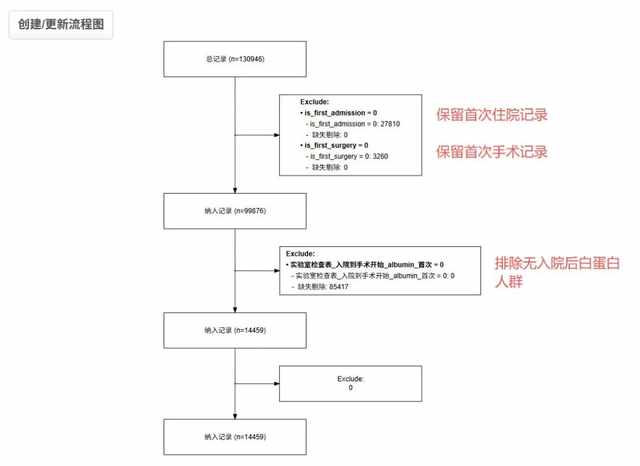
如果用简单合并,这条记录只会被算一次,要么丢了术前信息,要么丢了术后信息,这样的数据用于分析则无法避免偏倚。因此,为了分辨这条检验结果对手术1 来说是术后阶段、对手术2 是术前阶段,我们需要将数据的相对时间与两台手术各自开始 / 结束时间的比较。让同一条数据记录在两次手术中形成两种符合实际临床的阶段。第一步:将数据定位到具体维度(每条记录 × 每台手术)把一次住院内的某条检验 / 诊断 / 用药记录,与该次住院的每一台手术都配对一次。于是"第 5 天检验"会同时生成两行:一行归属手术1,一行归属手术2。对该记录所生成每一行,用自带的相对时间,和对应那台手术时间轴比较。那么这条检测结果对手术1将标记为"术后",对手术2则标记为"术前"。当手术因素不影响研究人群,不作为研究要素时,选择首次住院、首次手术,可以解决重复数据带来的偏倚;对于将手术作为暴露的研究,保留特定类型的首次手术,可排除后续同类型手术造成的污染。把上面三个步骤串起来,一句话概括核心逻辑就是:以"手术(op_id)"为锚点,先理时间、再定阶段、最后提取变量。最近,我们团队推出了INSPIRE数据库平台,可基于上文所述的逻辑进行快速的数据提取。我们以“入院后白蛋白对术后内分泌并发症的影响”为例,展示平台对多次手术患者事件发生生存时间的计算过程。变量勾选:支持中英文检索、模糊检索限定时间:对所需提取的各个变量设置相应的时间窗和条件数据匹配:平台自动基于设置好的条件匹配变量数据,并考虑多次住院、多次手术公共数据库的价值毋庸置疑,但它高高的门槛,长久以来把许多有想法的研究者挡在门外——不是不会做研究,而是倒在了"数据整理"这道坎上。于是,我们集中力量、历时一个多月,打磨出了 INSPIRE 数据库平台。我们的平台把本文所讲的方法转化为一条标准化流水线——以手术为锚点,做阶段化时间匹配,再完成暴露 / 协变量 / 结局的整合。- 曾经需要数周甚至数月、且极易出错的原始数据整理,如今被压缩为数小时即可完成的平台操作;
- 配合内置的数据整理系统与分析系统,打通了从数据提取到统计分析的全流程。
我们希望做的,是把最耗时最易出错的部分交给平台,把研究设计的巧思、临床问题的洞察、文章撰写的表达完整地交给研究者。希望每一个好的科研想法,都不要倒在数据整理的第一步。重磅!郑老师团队的INSPIRE整理分析平台已正式上线,我们还推出了INSPIRE数据库一对一论文分析指导,手把手带你开拓这一发文新赛道,抢发SCI!
价格表:
INSPIRE数据库一对一指导:3999元/篇文章(赠送两年的对应平台使用权)
相关服务:
✅买1年送1年,共2年的平台使用权限
✅赠送Inspire数据库全套课程
✅使用在线平台进行数据提取、分析的一对一指导
✅优先更新综合性指标
- 可以添加下方助教微信咨询详情,或搜索微信号:data5520。
- 可开技术服务费、培训费、咨询费等发票;可出具课程学习通知方便报销,可以对公转账。