BioEmu2:生物分子结构与动力学的基础模型
摘要
在结构生物学与计算医药领域,研究人员长期面临着一个核心矛盾:以 AlphaFold 为代表的传统折叠模型虽然极其精准,但给出的往往只是尖锐、单一的“静态快照”(Snapshot);而生命活动的本质却是
五维评分
正文
在结构生物学与计算医药领域,研究人员长期面临着一个核心矛盾:以 AlphaFold 为代表的传统折叠模型虽然极其精准,但给出的往往只是尖锐、单一的“静态快照”(Snapshot);而生命活动的本质却是高度柔性与动态的(Flexible)。如果改用传统的全原子分子动力学(MD)模拟去捕捉这种动态,往往需要消耗数周甚至数年的 GPU 算力。
为了填补“静态结构预测”与“高昂动力学模拟”之间的鸿沟,微软研究院 AI for Science 团队(Frank Noé 领衔)推出了全面进化的第二代生物分子基础模型——BioEmu2。
不同于传统的MD模拟或者结构预测模型,BioEmu2 将“静态结构预测”、“热力学平衡态采样”、“跨时间尺度动力学推演”以及“万级残基超大复合物装配”四大核心功能融为一体,构建了一套完整的生物分子模拟工作流。
一、功能基石:全分子类型的 SOTA 静态结构预测
“ 生物分子的三维结构是一切动力学演化的基础。” 在深入动态模拟之前,一个合格的基座模型必须首先具备顶级的静态折叠能力。
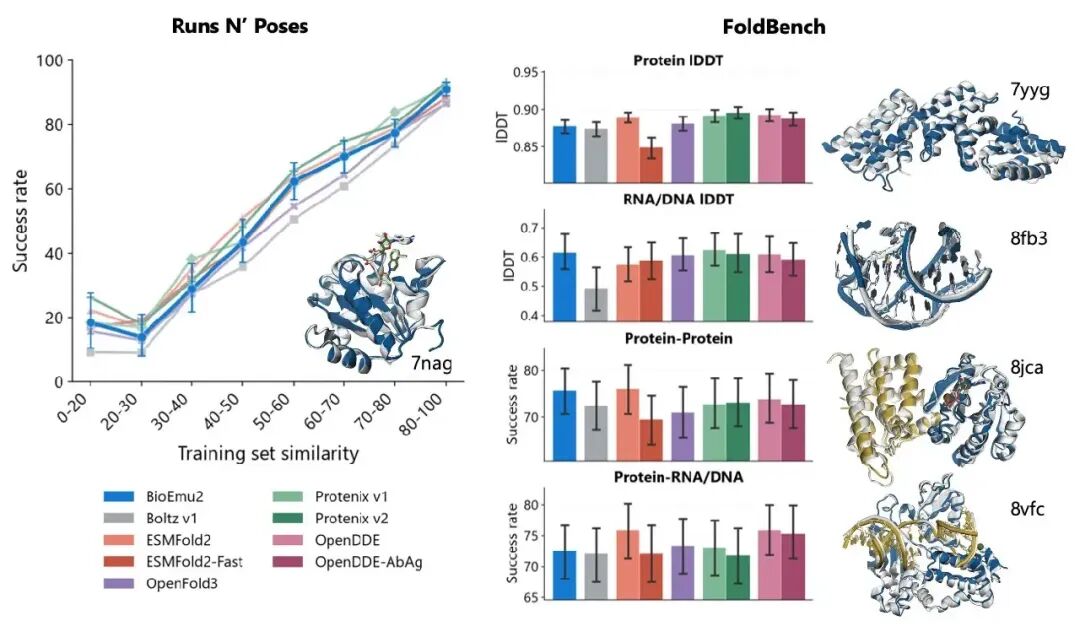
在结构预测模式(Structure prediction mode)下,BioEmu2 展现出了不错的能力。在采用完全相同的训练与测试集划分标准下,其预测精度全面比肩当前业界的顶尖折叠模型(如 Boltz v1、OpenFold3、Protenix v1/v2、ESMFold2 及 OpenDDE):
全分子覆盖的 FoldBench 评测:无论是单体蛋白质(7yyg)、RNA/DNA 核酸折叠(8fb3),还是复杂的蛋白质-蛋白质互作界面(8jca)与蛋白质-核酸复合物(8vfc),BioEmu2都可以预测。
二、核心功能一:热力学平衡态采样(分钟级复刻数年 MD 算力)
有了扎实的静态结构基本功,BioEmu2 的第一个杀手锏是平衡态采样模式(Equilibrium sampling mode)——它不满足于给出一张静止图片,而是直接生成分子在生理环境下的全套构象系综与热力学自由能景观。
通过海量分子动力学(MD)模拟数据的训练,BioEmu2 在这一功能下实现了三大突破:
1. 算力降维打击与化学级精度
传统 MD 模拟需要耗费数个“GPU·年”(GPU-years)才能遍历的构象分布,BioEmu2 仅需几分钟的 GPU 算力(GPU-minutes)即可生成。
在涵盖单体蛋白、蛋白质二聚体和蛋白-配体的基准测试中,其自由能曲面的预测误差低至 ,并能覆盖传统 MD 50% 至 100% 的亚稳态构象,状态覆盖率远超 Boltz-2 和 Protenix v2 等静态模型。
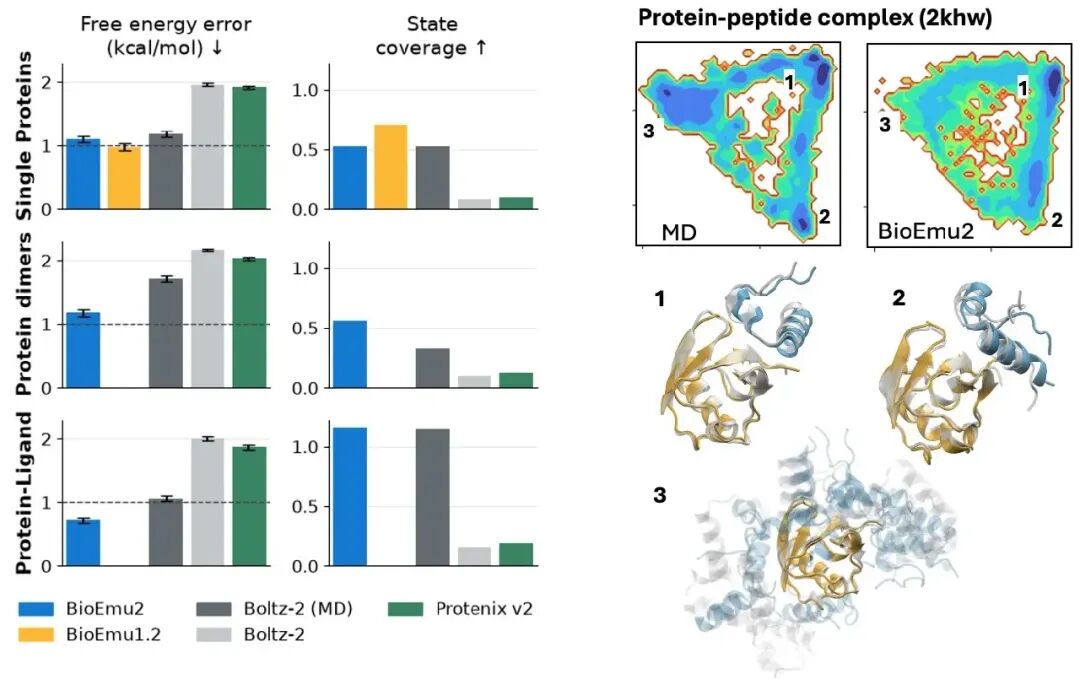
如图可知,相比于BioEmu1,BioEmu2新增加蛋白质多聚体、蛋白质-小分子模拟功能,模型功能更加全面。
需要注意的是,虽然 BioEmu2 在蛋白质-多肽复合物(2khw)中,还原了 MD 模拟出的 3 个核心亚稳态能谷。但,只是探索到了多构象的存在,针对2、3号位置的自由能预测中,并没有给出很好的提示。这告诉我们,在探索多构象时,比起能量的提示,或许更应该关注多种结构给我们的指示。
2. 揭示酶催化的底物诱导构象变化
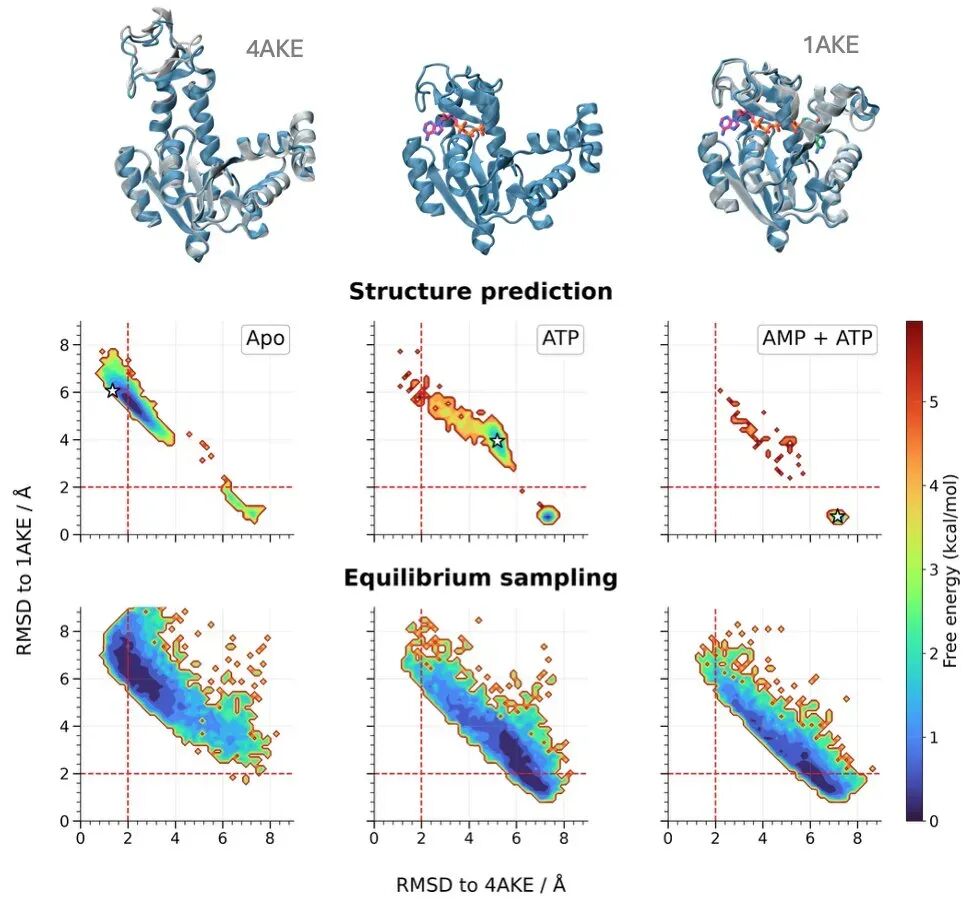
以催化 的经典酶腺苷酸激酶(Adenylate kinase)为例,静态预测只能在图谱上留下孤立的几个点,而 BioEmu2 的平衡态采样则完整还原了催化循环中的构象演变全景:
3. 赋能药物研发:展示 Holo/Apo 构象
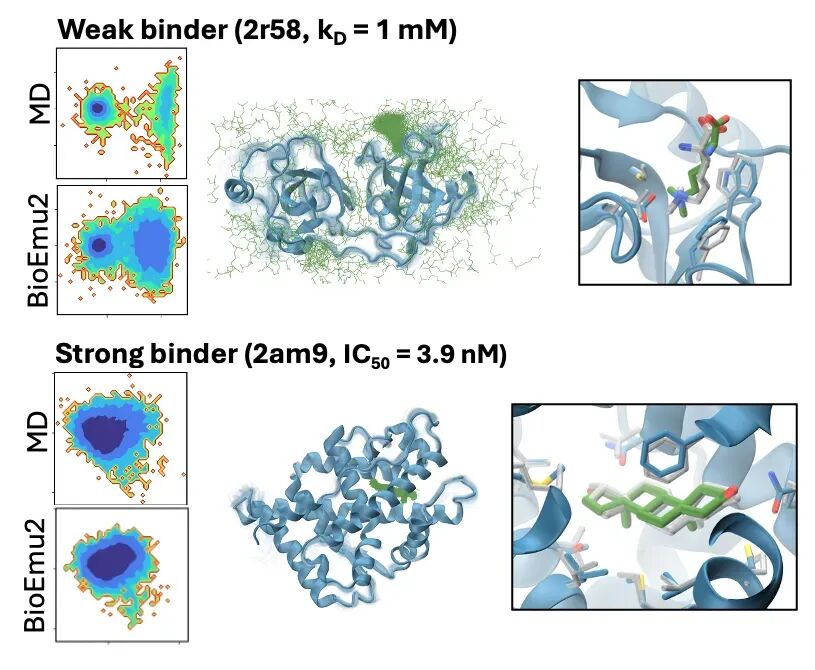
在药物筛选中,无论药物亲和力高低,BioEmu2 的平衡态采样都能够很好的捕捉药物结合蛋白质后的构象变化:
弱结合配体(Weak binder,如 2r58,):模型预测出极其宽泛的构象云,小分子不仅在正构口袋内晃动,还在蛋白质表面发生大量非特异性接触。这或许可以为在结构转变时,蛋白产生的隐匿口袋挖掘提供一定的帮助。
强结合配体(Strong binder,如 2am9,):自由能面呈现单一深谷,采样出的小分子姿态高度一致,被死死锁定在活性结合口袋中心。
三、核心功能二:物理时间轴上的连续动力学推演
平衡态采样解决了“有哪些构象、概率各是多少”的热力学问题,但无法给出构象演变的时间先后顺序。为此,BioEmu2 推出了最具颠覆性的功能——动力学推演模式(Dynamics mode),使其成为目前唯一能够预测时间动力学的 SOTA 生物分子基础模型。
隐式转移算子(Implicit Transfer Operators):借助这一数学框架,BioEmu2 能够将已知的或预测出的静态结构沿着时间轴直接向前推演。
跨越飞秒瓶颈:传统 MD 受限于化学键高频振动,时间步长只能设为飞秒()级别;而 BioEmu2 可以直接按纳秒()、微秒()级别的大步长推进,甚至一步跨越到平衡态。
在腺苷酸激酶的动态模拟中,BioEmu2 以 为步长,连续推演了长达 的运动轨迹,清晰记录下当 ATP 稳固结合在口袋内(RMSD 仅 )时,酶的盖子结构域(LID domain)重新打开的动态过程。
四、核心功能三:实验约束融合与万级残基“超大分子机器”结构预测
当研究尺度从单个酶分子扩大到细胞内的超大型生物大分子复合物(Mega-Dalton complexes)时,研究人员会遇到两个棘手难题:一是大型复合物往往由细胞机器组装而成,并不处于单纯的热力学平衡态,纯盲测极易出错;二是上万个氨基酸残基会导致单卡显存爆炸。BioEmu2 对此给出了软硬结合的解决方案:
1. 极少量实验数据引导装配(Experimental Data Integration)
BioEmu2 支持将交联质谱(XL-MS)、点突变或电镜等实验先验作为条件约束输入模型。以包含 4 条链、共 4,020 个残基、跨度达 的大型复合物 8WY8 为例:
上方无约束纯盲测(No contacts):4 条蛋白链错误地蜷缩挤压在中心(,,)。
下方仅引入 1 个接触约束(C:Asn 202-D:Asn202):仅仅告诉模型 1 处亚基间的接触位置,BioEmu2 便瞬间理清了对称装配关系,将 RMSD 暴降至 ,lDDT 大幅提升至 。
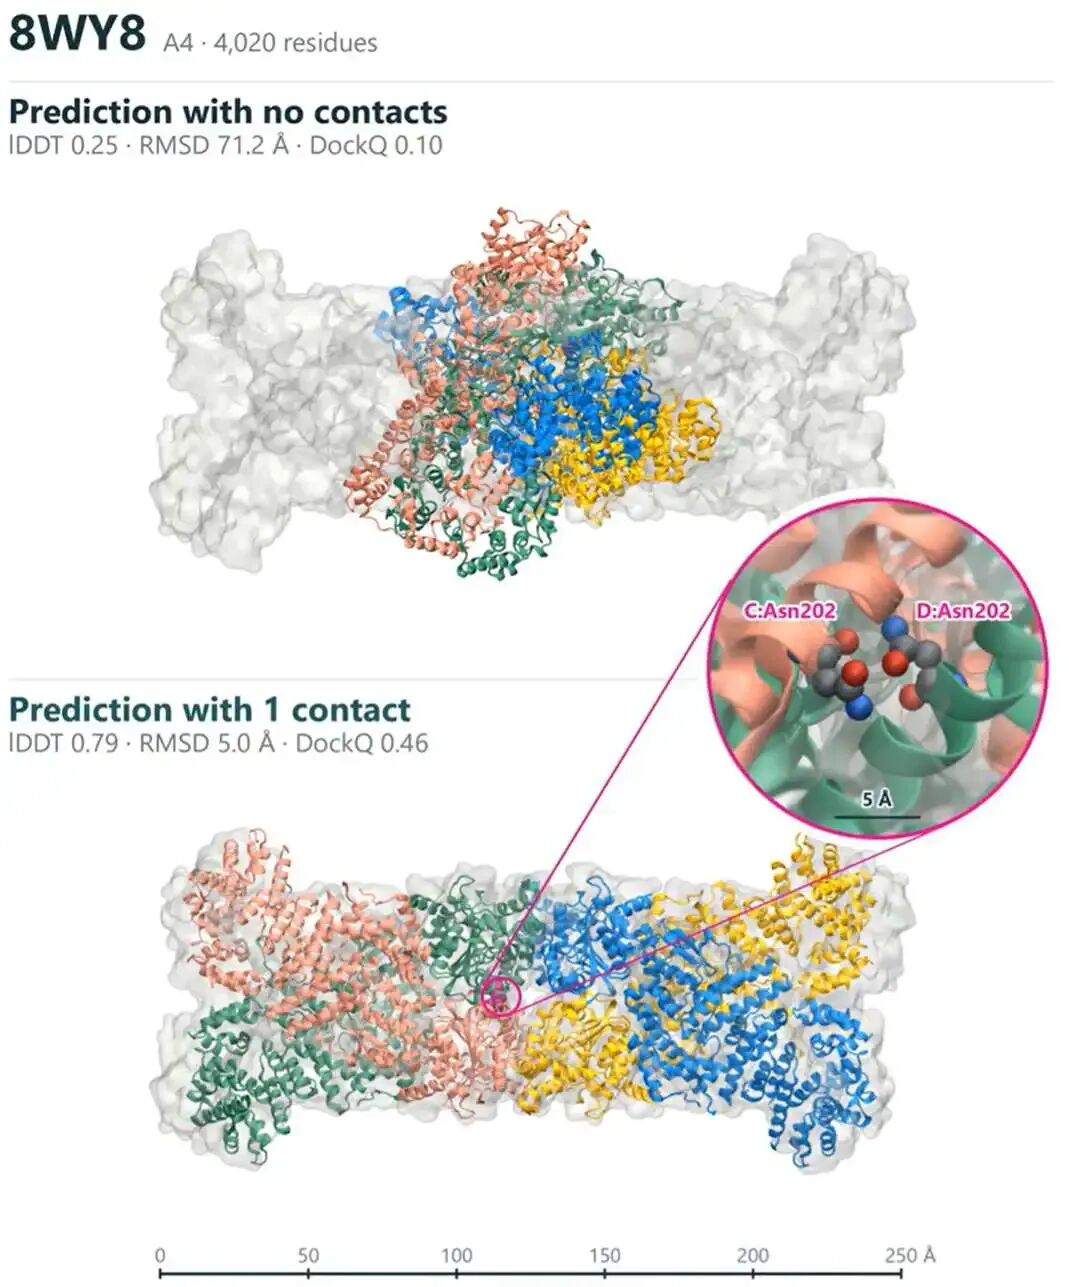
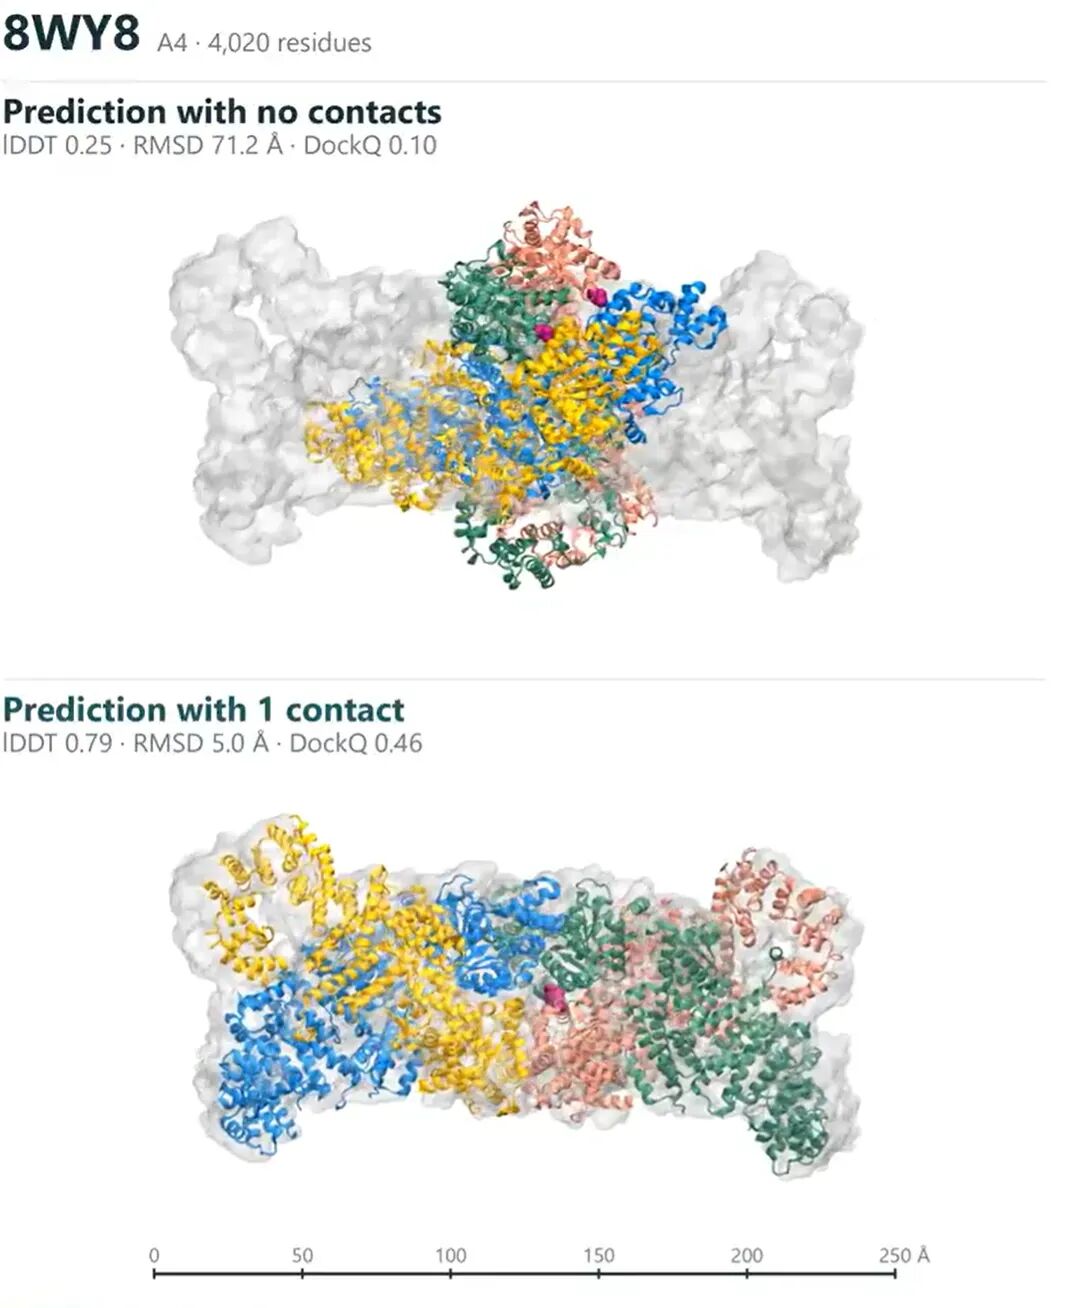
在旋转180°后可以看到,这个Example蛋白的选取是非常取巧的。从旋转180°后可以看到,无约束预测的失败在于预测的粉色蛋白质链选择错与之结合的蛋白质链(应该与绿色结合,而非蓝色蛋白质链)。这个Asn202的约束其实是明确告诉了蛋白质的结合模式,而非BioEmu2本身学到了多聚体应该如何结合。
但从另一个角度来看,如果可以仅从质谱或者蛋白质胶这种相比于电子显微镜简单的湿实验线索入手,BioEmu2就可以很好的完成对蛋白质结构的修改,对于大部分湿实验研究而言,未尝不是一种进步!
2. 多 GPU 并行架构支撑 10,000+ 残基体系
在工程底层,BioEmu2 的运行分为两个核心阶段:先由主干网络(Trunk embedding)提炼序列与残基对的高维特征表征(只需运行一次),再由扩散生成模块(Denoising)在特征引导下反复去噪生成三维构象。
巨型复合物精度验证:在 9ISQ(3,508 残基)、8DOL(3,558 残基)、9Q3J(4,040 残基,RMSD 低至 )和 8WW8(5,832 残基)等巨型同源多聚体上,模型预测结果与实验冷冻电镜表面完美贴合。
多卡线性扩展:在针对 16,000 残基 超大规模体系测试中,由主干网络(Trunk embedding)进行一次前向计算,得到序列与残基对的高维特征表征,再引导后续的扩散生成模块(Denoising)生成三维构象。
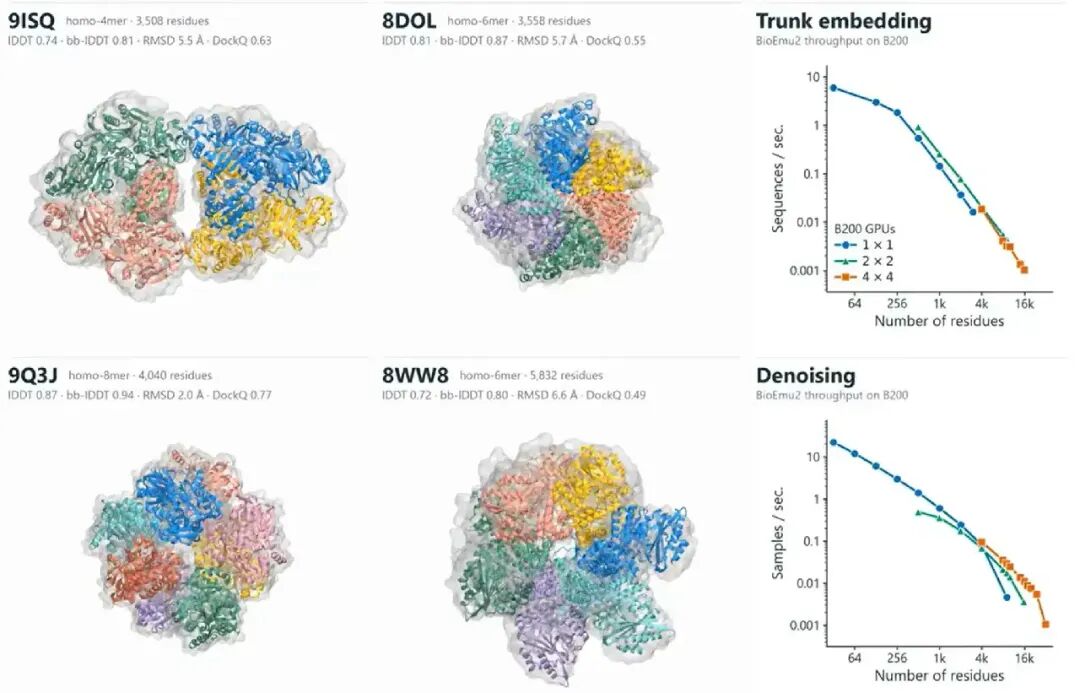
由图中可知,低于1000个氨基酸长度的蛋白质,BioEmu2都可以较为快速的模拟出蛋白质的轨迹。这说明,在日常一些非多聚体蛋白中,BioEmu2可以很好的帮助到湿实验的朋友来预测蛋白质构象,作为实验参考。
总结
BioEmu2 将传统动力学数年的计算压缩至分钟级,或许将构象采样带入新的时代。但这并不意味着分子动力学模拟(MD)的消亡,而是其生态位的重塑——从繁重的常规采样“必须工具”,转变为提供物理基准的“黄金标尺”。
然而,BioEmu2 真正的评价,不在于展示的例子效果有多目惊艳,而在于能否在经受真正科研场景下冷门靶点与复杂体系的考验。它究竟是颠覆时代的利器还是特定案例的秀技,最终的裁决权,始终在各位实验者的手里。期待各位读者的使用反馈!!
编辑:苏北山
审核:寿三水
参考引用
https://github.com/microsoft/bioemu2
https://x.com/FrankNoeBerlin/status/2112472173336240499