普通医学研究者如何用Agent发SCI论文的高分范式
如何用Agent发SCI论文?看看这篇普通医学研究者也能模仿的高分论文范式
摘要
2026年7月22日,微信公众号“医学论文与统计分析”发布文章,介绍普通医学研究者利用AI Agent发表SCI论文的范式。文章通过实例展示如何将Agent应用于研究设计、数据分析及论文撰写,并强调其可模仿性。该文为研究者提供了一种高效发表高分论文的新路径,但未提及具体期刊或时间节点。
AI 主编 · 推荐理由推荐理由
AI辅助科研是药企注册与医学事务团队提升文献产出效率的新趋势,建议关注并评估合规风险,可借鉴其方法优化内部学术支持流程。
五维评分
正文
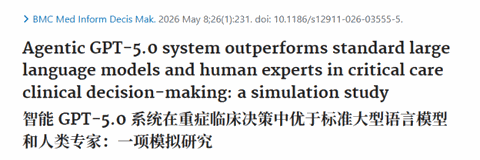
今天给大家介绍一篇普通医学研究者也能模仿的高分论文范式:GPT-5主诊+Gemini复核。
医疗大模型真正进入临床时,最危险的问题往往不是“完全不会”,而是第一次回答看起来很专业,却漏掉关键诊断、剂量、时间节点或处置步骤。单次问答没有复核环节,一处遗漏就可能直接进入最终答案。
这篇文章的作用,就是提供了一套非常简单的解决方案:不训练新模型,也不搭建复杂医院系统,而是让两个现成大模型分工。一个模型负责主分析,另一个模型像会诊医生一样独立复核;发现问题后退回修改,再输出最终结论。
它解决的不是“模型有没有医学知识”,而是“怎样用第二意见和反复核查,减少单次回答中的临床遗漏”。
这篇文章研究目的是什么?
作者想回答一个非常清楚的问题:在危重症临床决策中,GPT-5.0主分析+Gemini 2.0 Flash交叉验证的Agent系统,能否比单模型直接回答和临床医生获得更高的准确性与指南依从性?
进一步说,研究关注三个目标:
比较Agent工作流、单模型回答和临床医生的总体表现;
观察第二个模型能否发现初始答案中的真实错误或遗漏;
评价多轮复核带来的准确率提升,是否值得额外的时间和调用成本。
作者选择了两个具有明确评价标准的危重症任务:
酸碱平衡紊乱判断:识别原发紊乱、代偿状态及混合性异常。
脓毒症一小时集束化治疗:评价乳酸、血培养、抗菌药物、液体复苏和血管活性药物。
作者用了哪些病例?
研究共设置45个文本病例,由重症医学、急诊医学和肾脏病学专家组成的独立小组开发。
20个酸碱平衡病例:覆盖单纯代谢性、单纯呼吸性以及双重、三重混合性紊乱。
25个脓毒症病例:覆盖典型脓毒症、脓毒性休克、多器官功能障碍和非典型表现。
比较了哪些对象?
Gemini 2.0 Flash单次回答。
GPT-4o单次回答。
GPT-5.0与Gemini 2.0 Flash组成的Agent系统。
20名临床医生,包括10名急诊医学专家和10名重症医学专家。
所有回答均进行匿名化,再由不知晓答案来源的医生依据预先制定的金标准评分。
这套Agent到底怎么工作?
第一步:GPT-5.0进行初步分析
GPT-5.0作为主推理模型,对病例进行结构化分析,输出诊断、处置建议及支持依据。
第二步:Gemini独立复核
Gemini先独立分析同一病例,随后审查GPT-5.0的答案,寻找遗漏的酸碱紊乱、错误的代偿判断、不合理的用药以及遗漏的脓毒症bundle项目。
第三步:迭代修正
如果Gemini发现分歧,系统将异议反馈给GPT-5.0重新分析。多数病例经过2至3轮,复杂病例最多需要4轮。
第四步:形成最终共识
GPT-5.0综合初始分析与Gemini的复核意见,生成最终建议并保留修正路径。
整个流程是:GPT-5主诊 → Gemini独立会诊 → 发现分歧 → GPT-5复核修改 → 最终答案
结果怎么样?
真正拉开差距的是复杂病例
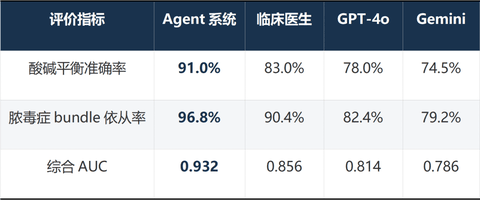
简单酸碱问题中,各组表现差距不大。进入混合性酸碱紊乱后,单模型最常见的错误是识别了主要异常,却遗漏同时存在的第二或第三种紊乱。复核Agent的价值,正是在这里体现出来。
Gemini在31/45个病例中提出疑问,其中24例产生了具有临床意义的修正;平均每例经过2.4轮迭代。
这篇文章最值得学习的地方
如果只是把GPT-5和Gemini串联起来,研究价值其实有限。作者真正值得学习的地方,是把“复核是否有效”设计成了可评价机制。
预先规定的有效修改包括:
找到遗漏的第二或第三种酸碱紊乱;
修正错误的代偿判断;
修改抗菌药物选择、剂量或使用时间;
补充遗漏的脓毒症一小时bundle项目。
调整语序、改变格式或重复原有建议,不被视为有效修正。这样,研究就能回答:第二个Agent到底发现了多少真正影响临床结论的问题?
Agent系统比单模型更慢,但比医生完成同样病例评价快约47%。它体现的是典型的准确率—成本取舍:用更多调用和推理轮次换取更完整的临床答案。
它能证明“Agent超过医生”吗?
还不能。标题很吸引眼球,但研究结论必须放回实验设计中理解。
基础模型与Agent架构混杂
Agent组使用GPT-5.0作为主模型,而单模型对照是GPT-4o和Gemini。研究没有设置“GPT-5单次回答”对照,因此无法判断提升来自更强模型、交叉复核,还是二者共同作用。
样本量较小
研究只有45个模拟病例;混合性酸碱紊乱和非典型脓毒症亚组分别只有6例和5例,亚组结果只能视为探索性发现。
医生不能查阅资料
参与医生不能使用指南、数据库或参考工具,但真实临床中医生通常可以查阅指南并与同事讨论,这种不对称可能低估真实医生表现。
统计表述需要谨慎
论文设定Bonferroni校正阈值为0.0083,但部分Agent与医生比较的P值高于这一阈值。引用“所有比较校正后仍显著”等结论时,应回到原始统计表进一步核查。
更稳妥的结论是:在结构化文本病例中,“强模型主分析+另一模型独立复核+多轮修正”比单次调用模型表现更好。
这类文章该怎么模仿?
1️⃣选择一个具有明确指南或金标准的临床任务。
2️⃣整理一批经过脱敏的病例。
3️⃣设置同一强模型的单次回答基线。
4️⃣设置主分析Agent与独立复核Agent。
5️⃣规定哪些错误必须退回修改。
6️⃣记录每轮分歧、误报与有效修正。
7️⃣邀请临床专家进行盲法评分。
8️⃣比较准确性、安全性、时间与调用成本。
适合迁移的方向包括:急诊胸痛分层、抗菌药物选择、肿瘤治疗审核、ICU液体管理、肾功能异常用药调整、围术期风险判断以及临床指南一致性审查。
如果想把研究做得更扎实,建议至少补充以下对照:
同一强模型单次回答;
同一强模型自我反思;
同一模型多次采样后投票;
不同模型交叉复核;
医生单独判断;
医生使用Agent辅助判断。
同时加入危险建议率、关键项目遗漏率、指南冲突率、复核误报率和单位性能增益成本,论文的临床价值会更完整。
普通医学研究者的机会在哪里?
这篇文章再次说明,医疗Agent论文不一定要训练模型。真正重要的是把临床问题设计成有明确输入、有标准输出、有专家金标准、有可量化错误和安全红线的研究任务。
高质量病例、临床指南、专业评分标准,以及对真实临床错误的理解,往往比GPU更稀缺。模型负责生成答案,Agent负责组织推理与复核流程,专家负责判断输出能不能用——这正在成为医疗AI研究中一条非常实用的路线。
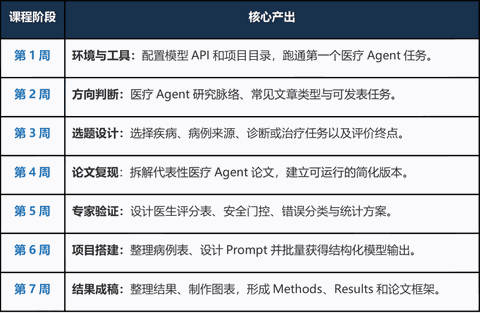
如何掌握方法,快速做出一篇医疗Agent论文?最省时间的方法,是完整跑通一次从病例整理、Agent搭建、专家评分到SCI写作的闭环。
![]() 我们团队最新开设 “ 医疗Agent论文实战营:从病例到SCI论文雏形 ” ,课程采用7周直播实战形式,围绕一个统一示范疾病逐步完成完整项目。你也可以把课堂模板迁移到自己的专科和病例数据。
 我们团队最新开设
本周日开启第三周直播学习,欢迎报名!现在加入还来得及,购买后可先观看前两周内容回放,根据教程完成Claude Code安装与开发环境配置,VS Code 与课程模板包配置,有主讲老师与助教答疑指导
不要求训练大模型,不要求深度学习基础。用一批真实病例,完成一套可评价、可统计、可迁移的医疗Agent研究。
7周课程会带你完成什么?
培训费用与时间
💰 训练营费用:1999元
🕐训练营时间:7月26日开启第三周内容学习,一周一训,每周日上午9:00-12:00线上直播。
报名方式
 。
 |  |
如果你也想把手里的病例变成一套可运行的医疗Agent研究,现在就加入新一期实战营。