真实世界临床研究专栏:敏感性分析理论与方法课程上线
《真实世界临床研究(回顾性数据分析)》专栏课程:敏感性分析理论与方法
摘要
2026年8月6日,医学论文与统计分析平台发布《真实世界临床研究(回顾性数据分析)》专栏课程,聚焦敏感性分析理论与方法。课程面向临床研究者,系统讲解敏感性分析在回顾性数据分析中的应用,包括方法选择、实施步骤及结果解读,旨在提升真实世界研究的稳健性。
AI 主编 · 推荐理由推荐理由
真实世界证据是药械注册和监管决策的重要支撑,敏感性分析是评估结果稳健性的关键。建议注册、医学事务及统计人员学习,以提升研究质量,满足监管机构对真实世界证据的严格要求。
五维评分
正文
本文整理自郑老师统计团队《真实世界临床研究(临床回顾性数据分析)》专栏课程,重点介绍敏感性分析理论与方法。完整视频教程,请点击文末“阅读原文”获取。
审稿人想让我加一个敏感性分析,到底是什么方法,应该要怎么做 ?今天这篇推文就给大家讲清楚。
在观察性研究中,我们常常被问到一个“灵魂拷问”:你的结果可靠吗?如果换一种缺失数据处理方法,结论还会一样吗?如果多调整几个协变量,效应会不会消失?”这些问题直指研究的稳健性。而回答它们,正是敏感性分析的使命。
什么是敏感性分析?
先看两个词:敏感 vs 稳健。
研究结果是稳健的(Robust),即使改变了某些条件或者调整了某些因素以后,结果依然稳定;反之,如果条件稍有变动,结论就大相径庭,说明结果过于敏感(Sensitive)——这时候,我们使用结论就得格外小心。
著名的著作“流行病学词典” 给出的定义是:
敏感性分析是一种通过改变方法、模型、未测量的变量值及假定来考察结果的改变程度,以确定评估方法的稳健性。敏感性分析的目的是识别那些最易被可疑的,无支持的假设影响的结果。
简单说:它是观察性研究的“压力测试”。
为什么要做敏感性分析?
观察性研究没有随机化,面临大量“干扰源”。
缺失数据如何处理?
指标定义(暴露、结局、协变量)如何界定?
回归模型选哪个?协变量调哪些?
数据来自异质性人群,是否存在偏倚?
未测量的混杂因素是否暗中作祟?
这些问题每个都可能“带偏”结论。敏感性分析就是主动“拷问”自己的结果,看它在不同合理设定下是否仍然站得住脚。
敏感性分析应该怎么做?
1️⃣ 换“分析人群”
采用不同的分析集(如ITT、FAS、PPS)或筛选特定亚组(如只选基线高认知人群、排除早期发病者),看结果是否一致。
2️⃣ 换“分析数据”
离群值:剔除离群值再跑一遍,或改用稳健回归;
缺失值:用完全数据(不填补)跑一遍,与多重插补后的结果做对比。
3️⃣换“指标定义”
改变暴露因素或结局的定义(如定量转等级、按不同切点分组),重新进行分析。
4️⃣换“统计学方法”
单因素分析换成多因素回归;
普通Cox回归换成竞争风险模型(Fine-Gray模型),检验方法选择带来的影响。
5️⃣ 换“协变量控制”
采用多模型策略或改用倾向性评分匹配、加权等方法,观察效应值的变化。
6️⃣ 检验“模型假定条件”
正态性:做log转换后比较参数与非参数检验结果;
线性:改用限制性立方样条(RCS)或趋势性检验;
等比例风险:改用限制性平均生存时间(RMST)。
7️⃣评估“未测混杂”
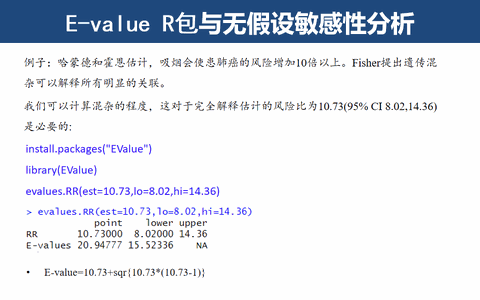
直接计算 E-value:
E值大 → 需要很强的未测混杂才能推翻结论,结果较稳健;
E值小 → 很弱的混杂就可能推翻结论,需谨慎解读。
一句话概括,就是针对研究中关键的方法学决策点(如缺失数据处理、协变量调整策略、未测混杂控制等),逐一采用合理的替代方案进行重复分析,若主要效应估计值的方向保持一致且置信区间重叠,则认为结果具有较好的稳健性。
针对上述敏感性分析内容,我们的 “ 真实世界临床研究(临床回顾性数据分析) ” 课程中有详细讲解,并且结合文献案例,带你快速掌握。
部分课程截图:
本文内容摘自郑老师统计专栏课程《真实世界临床研究(临床回顾性数据分析)》,点击左下方“阅读原文”可以观看完整讲解视频及获取全套课程资料。
更多医学统计培训课程(含因果推断,机器学习,公共数据库挖掘,临床数据分析等):
购买方式
可以添加下方助教微信咨询详情,扫描购课二维码购课。
可开技术服务费、培训费、咨询费等发票;可出具课程学习通知,方便报销,可以对公转账。
助教二维码,联系咨询
购课二维码,直接购买