风暴统计平台零代码实现预测模型论文完整分析
预测模型分析工具来了!风暴统计平台零代码实现一篇预测模型论文完整分析流程
摘要
2026年7月7日,中国医学论文与统计分析公众号发布消息,介绍风暴统计平台可零代码完成预测模型论文的完整分析流程。该平台旨在简化统计分析,使研究者无需编程即可进行预测模型构建与验证,适用于临床研究及药械相关数据分析。
AI 主编 · 推荐理由推荐理由
对药企注册和医学事务人员而言,该平台可加速临床研究数据分析,提升论文产出效率,建议关注并评估其合规性与适用性。
五维评分
正文
每次开组会都被导师催进度?没数据、没经费,不知从何下手?其实,利用公共数据库发一篇3分+的SCI并没有想象中那么难!
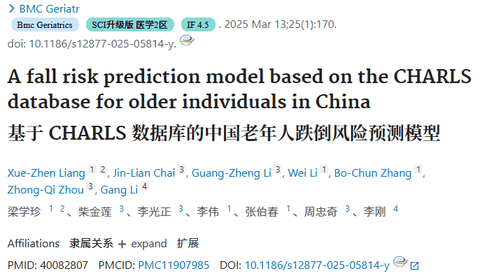
如今,预测模型已成为临床科研发文的“绝对主力”。今天,我们将以经典的Logistic回归为例,带你完整复现从“模型构建”到“验证评价”的全流程。跑通这套底层逻辑,你就能轻松举一反三!
本教程不讲晦涩理论,只给最实用的发文SOP,涵盖以下8大核心步骤:
① 随机数据拆分
② 基线特征描述
③ LASSO回归与Logistic回归筛选预测因子
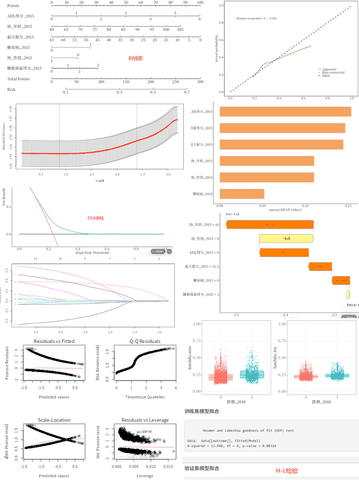
④ 绘制列线图(Nomogram)
⑤ 绘制ROC曲线并计算AUC值
⑥ HL检验(Hosmer-Lemeshow test)
⑦ 绘制校准曲线(Calibration curve)
⑧ 绘制DCA决策曲线(Decision Curve Analysis)


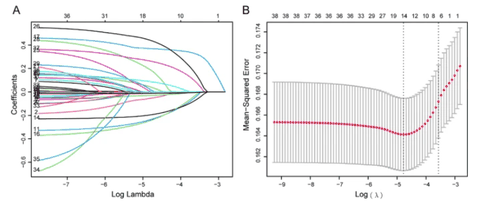
1.2 变量筛选(LASSO回归)
目的:从38个候选变量中筛选出与跌倒最相关的预测因子,避免过拟合。
具体步骤
使用LASSO回归对训练集数据进行分析。
通过10折交叉验证选择最优惩罚参数 λ(lambda)。
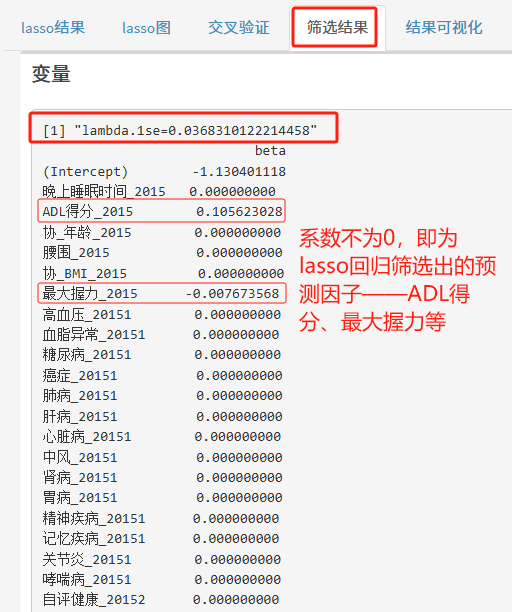
选择标准:1-SE准则(即最小偏差值的一个标准误范围内的最大λ),使模型更简洁。
LASSO将不相关变量的回归系数压缩为 0,仅保留非零系数的变量。
最终筛选出 13个潜在预测变量。
1.3 多因素Logistic回归(最终模型构建)
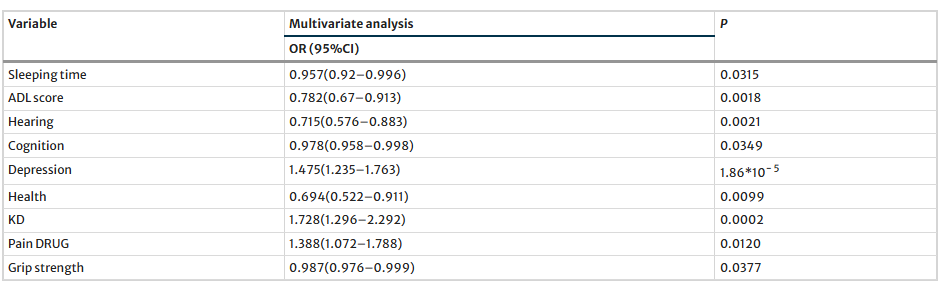
目的:在LASSO筛选的基础上,进一步确定独立预测因子,并计算OR值及95% CI。
具体步骤:将LASSO筛选出的变量纳入多因素Logistic回归模型,回归中p值小于0.05的变量组成预测模型。最终保留 9个独立预测因子。
1.4 列线图(Nomogram)构建
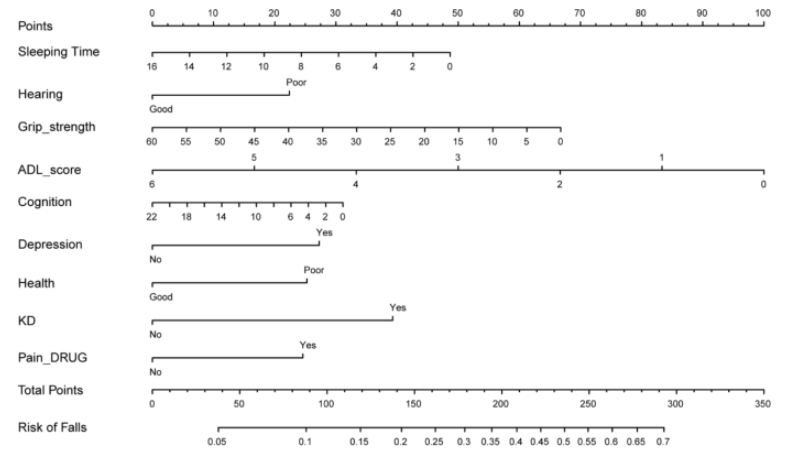
基于上述9个变量,使用R软件的 rms包 构建列线图。
列线图将每个变量的取值映射为对应的分数,总分再映射为跌倒风险概率(0.1 ~ 0.5),实现个体化定量预测。
1.5 模型性能评估(训练集 + 验证集)
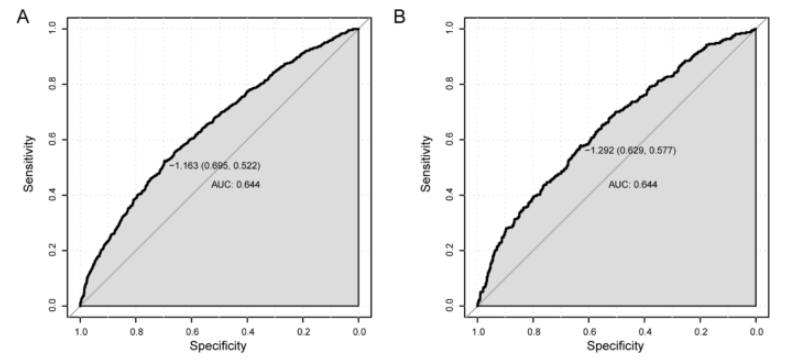
💠区分度(Discrimination)—— ROC曲线 + AUC
训练集:AUC = 0.644(95% CI: 0.621–0.666)
灵敏度 = 0.522,特异度 = 0.695
验证集:AUC = 0.644(95% CI: 0.611–0.678)
灵敏度 = 0.577,特异度 = 0.629
AUC接近0.65,提示中等偏低的区分能力。
💠校准度(Calibration)—— Hosmer-Lemeshow检验 + 校准曲线
训练集:χ² = 2.9609,df = 8,P = 0.9368
验证集:χ² = 4.0294,df = 8,P = 0.8545
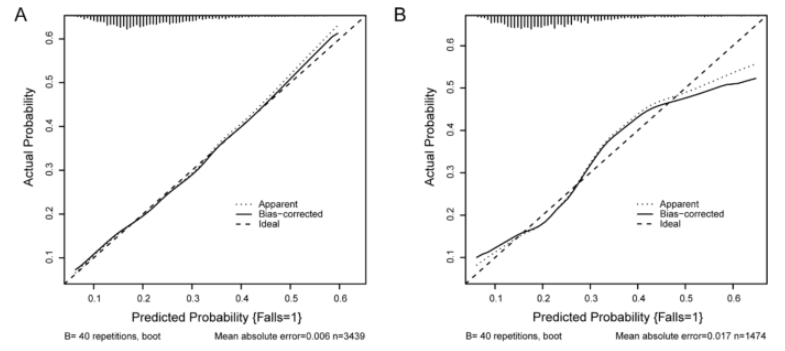
两者 P > 0.05,表明模型预测概率与实际观察概率无显著差异,拟合良好。
校准曲线(图4A/B)显示预测概率与实际概率基本沿45°对角线分布,一致性较好。
💠临床净收益——决策曲线分析(DCA)
使用DCA评估模型在不同阈值概率下的净收益(Net Benefit)。
结果显示:模型净收益在较宽阈值范围内高于“全部干预”和“全部不干预”两种极端策略,说明模型具有一定的临床实用性。
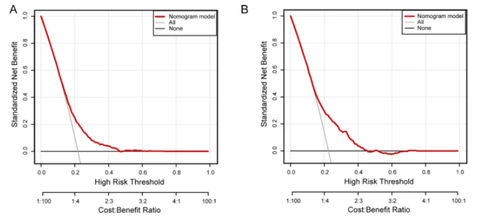
用于定量预测老年人跌倒风险的决策曲线图。
A. 使用训练集生成的DCA曲线。B. 使用验证集生成的DCA曲线。


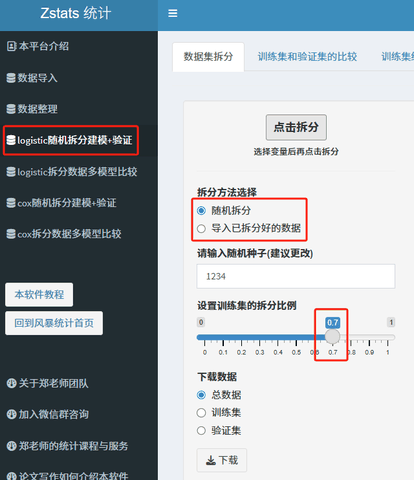
方式一:随机拆分法
选择此方式后,需设置随机种子和拆分比例。
随机种子对位数没有限制,其主要作用是保证拆分结果可复现,平台默认设为 1234。
拆分比例通过拖动滑条即可直观调整,蓝色部分代表训练集所占比例,其余部分即为验证集。
方式二:导入已拆分好的数据
若您已有拆分好的数据,可选择此方式。操作前,需先在原始数据中增加一列,用于标识每条记录属于训练集还是验证集。例如,新增一列名为“group”,用编码 1 表示训练集、2 表示验证集。
操作时,第一步选入该区分变量,第二步勾选代表训练集的编码值(如 1)。
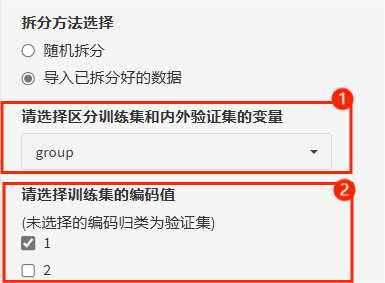
需要特别说明的是,“导入已拆分好的数据”不仅可用于内部验证,更重要的应用场景是外部验证——只需提前用一列变量区分训练集和外部验证集,即可按同样步骤完成设置。
🔶原文复现:这里我们按照原文献选择按照7:3比例进行随机拆分即可。
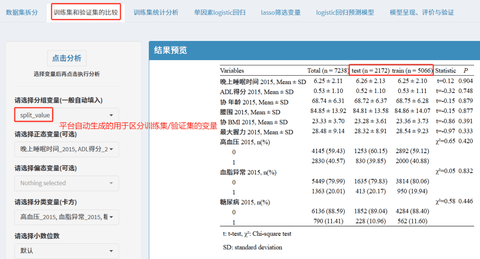
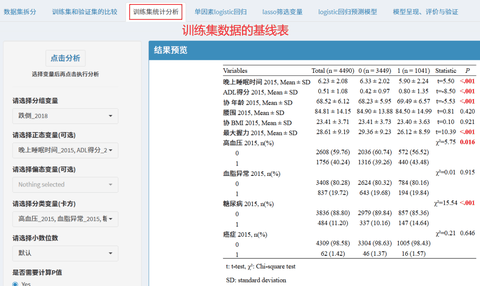
正态数据会使用均值±标准差表示,采用t检验进行组间比较;偏态数据会使用中位数与上下四分位数表示,采用秩和检验进行组间比较;分类数据会使用百分比表示,采用卡方检验及fisher法进行组间比较!
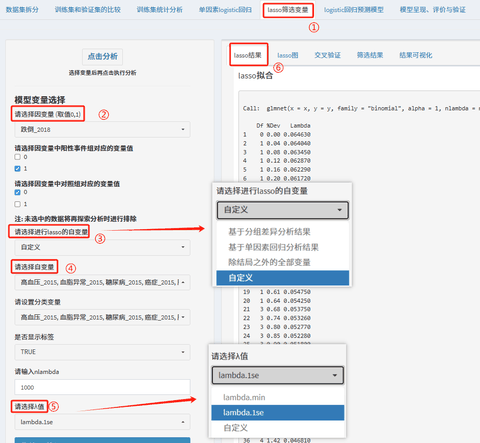
首先,选择因变量;
其次,选择进行LASSO的自变量,这里有多种选择,对应多种预测因子筛选套路。我们这里选择自定义。
第三,选择 λ 值,一般选择lambda.min或lambda.1se,分别代表均方误差最小时的lambda和距离均方误差最小1个标准误的lambda。
然后点击分析,即可查看LASSO回归结果。
2.3.1 LASSO回归结果
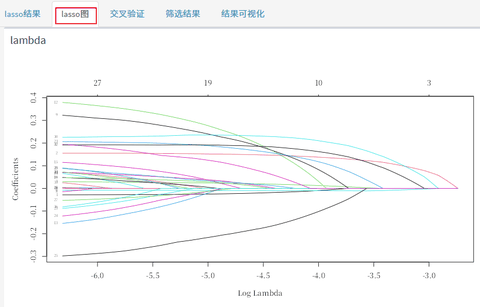
一般论文中会展示LASSO回归系数路径图与交叉验证图。
回归系数路径图:横坐标是λ(即lambda)的对数,纵坐标为变量的回归系数,上方的一行数字表示变量的个数,lasso回归的基本原理就是压缩系数,直至系数为0。
交叉验证图:用交叉验证的方法确定最佳变量个数。左边的虚线是对应的是lambda.min,右边对应的是lambda.1se。可以看到,选择lambda.1se时,筛选出的变量数量更少,模型也更加精简。
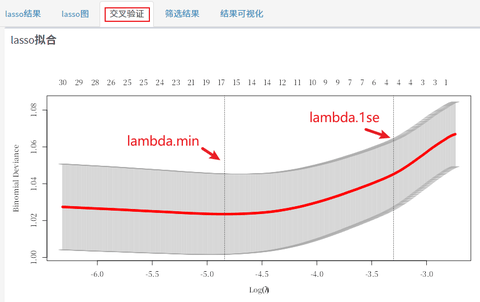
🔶原文复现:与原文一致,这里选择展示lambda.1se筛选结果,系数不为0,即为LASSO回归终筛选出的变量。
2.4 最终变量筛选——LASSO回归后,多因素logistic回归进一步筛选预测因子
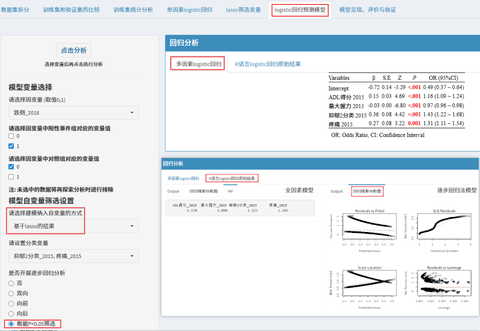
进入下一个模块——logistic回归预测模型,可以选择基于lasso的结果构建模型,下方选择是否开展逐步回归:
若选择否,则LASSO回归筛选出的变量全部用于构建预测模型;
若选择双向,向前,向后,则是对LASSO回归筛选出的变量开展双向,向前,向后逐步回归,逐步回归结果用于构建预测模型;
若选择根据P<0.05,则是对LASSO回归筛选出的变量开展多因素logistic回归,多因素回归有意义的变量(P<0.05)用于构建预测模型。
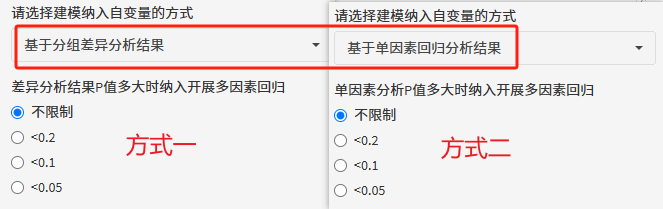
一、基于分组差异性结果
原理:根据自变量在分组比较中的差异性P值进行筛选。
操作:设定P值阈值(如0.05、0.1、0.2),低于阈值的变量进入多因素回归。
二、基于单因素回归结果
原理:根据单因素回归分析中的P值进行筛选。
操作:同样设定P值阈值,达到标准的变量纳入后续多因素分析。
两种方式的异同:两者的筛选逻辑非常相似,核心区别仅在于P值的来源——前者来自组间差异检验(如t检验、卡方检验),后者来自单因素回归分析。若选择“不限制”,则所有自变量均进入多因素回归。
三、自定义筛选
适用场景:当某些变量在临床或专业上被认为非常重要,但因样本量或数据分布等原因,在单因素分析或差异检验中未达到统计学显著水平时,可依据专业知识和文献依据,人为指定纳入模型。
优势:弥补纯数据驱动筛选的不足,兼顾临床意义与统计学要求。
总之,无论采用上述哪种筛选方式,完成自变量以后,进一步选择是否开展逐步回归
选择“否”:即执行传统的先单后多分析流程。
选择“是”:平台提供多种逐步回归算法:
双向逐步回归
向前逐步回归
向后逐步回归
基于P < 0.05原则的逐步回归(可保留P值大于0.05的变量,更贴合实际研究需求)
完成上述设置后,系统输出多因素Logistic回归结果,该多因素模型即为最终预测模型。列线图(Nomogram)中将包含多因素回归中的所有自变量。
2.5 预测模型构建好后,接下来开展模型呈现、评价与验证
包括ROC曲线与AUC面积,校准曲线与HL检验,列线图,模型混淆矩阵,DCA曲线和SHAP分析,均是点击分析,直接出结果。
这里简单复现案例文献的结果。