Nat. Methods | 兼具高灵敏度与高速度的概率式蛋白质结构比对方法
摘要
DRUGONE随着AlphaFold等蛋白质结构预测方法的快速发展,越来越多的蛋白质获得了接近实验精度的三维结构,使基于结构的同源性分析逐渐成为蛋白质功能注释和进化研究的重要手段。然而,现有蛋白质结构
五维评分
正文
DRUGONE
随着AlphaFold等蛋白质结构预测方法的快速发展,越来越多的蛋白质获得了接近实验精度的三维结构,使基于结构的同源性分析逐渐成为蛋白质功能注释和进化研究的重要手段。然而,现有蛋白质结构比对方法仍难以同时兼顾远缘同源识别灵敏度、比对精度与计算速度,特别是在包含多个结构域或具有较大构象变化的蛋白质中,这一问题更加突出。
研究人员提出了LoL-align,一种基于概率模型的快速蛋白质结构比对算法。该方法通过比较蛋白质内部Cα原子之间的距离关系,构建局部对数优势评分(local log-odds score,LoL-score),并采用迭代式概率比对策略识别结构保守区域。与依赖三维空间刚性叠合的方法不同,LoL-align能够在一定程度上容忍蛋白质构象变化,同时保持较高的残基级比对准确性。
在单结构域和全长多结构域蛋白质基准测试中,LoL-align的远缘同源识别灵敏度明显优于TM-align和Dali,并获得更高的整体比对质量。在SCOPe超家族水平上,其平均灵敏度分别比Dali和TM-align提高7.3%和9.9%。在包含2000个查询蛋白质的大规模测试中,LoL-align的运行速度约为TM-align的5倍、Dali的20倍。该方法已整合至Foldseek,为大规模蛋白质结构搜索、功能注释及进化关系分析提供了高效工具。
蛋白质序列和结构之间存在密切联系,但在长期进化过程中,蛋白质序列可能发生显著变化,而其三维折叠仍然保持相对稳定。因此,结构比对通常比序列比对更适合识别序列相似性较低的远缘同源蛋白质,对于揭示蛋白质进化关系和推断未知蛋白质功能具有重要价值。
近年来,AlphaFold2、AlphaFold3及其他结构预测模型极大地扩展了可获得的蛋白质结构数量。当前蛋白质结构数据库已包含数亿个预测模型,使蛋白质研究逐渐从依赖序列信息转向结合大规模结构信息的分析范式。
然而,结构数据规模的迅速增长也对比对算法提出了更高要求。理想的结构比对方法不仅需要识别远缘同源关系,还应准确确定残基之间的对应关系,并能够处理局部结构相似、结构域重新排列及构象柔性等复杂情况。传统TM-align通过优化蛋白质三维结构叠合寻找相似区域,在单结构域和相对刚性的蛋白质中具有较好表现,但在处理结构域之间发生相对运动的蛋白质时容易受到影响。Dali则通过比较蛋白质内部距离矩阵识别结构相似性,通常具有较高灵敏度,但计算开销较大,不适合直接应用于数百万乃至数亿个结构的大规模比对。
Foldseek通过将蛋白质结构编码为20状态的3Di结构字母表,并借助MMseqs2的高速搜索算法,大幅提高了结构搜索速度。不过,这种结构信息压缩和快速比对方式可能损失部分远缘同源识别能力及残基级比对精度。
因此,研究人员希望建立一种能够结合概率序列比对与三维结构距离信息的方法,在保持高灵敏度的同时,降低计算复杂度,并使其适用于完整多结构域蛋白质和大规模结构数据库。
方法
研究人员开发了LoL-align概率式蛋白质结构比对算法,通过比较查询蛋白质与目标蛋白质内部Cα原子之间的距离,建立衡量残基同源可能性的LoL-score。算法首先结合3Di结构字母替换评分与氨基酸BLOSUM62替换评分,利用向量化Forward–Backward算法计算残基对齐的后验概率,并选择高置信度的连续七残基片段作为初始锚点。随后根据锚点之间的结构距离关系计算LoL-score矩阵,重新估计残基配对概率,并将满足概率阈值的新残基加入锚点集合,通过反复迭代扩展比对区域,直至结果收敛。为提高计算效率,研究人员利用SIMD向量化技术并行处理动态规划计算,通过分块数值缩放避免概率运算中的上溢和下溢,同时复用动态规划矩阵减少内存占用。此外,研究利用SCOPe结构分类数据库训练轻量神经网络,将局部结构比对特征转换为蛋白质同源概率,并针对单结构域与多结构域蛋白质设计不同的评分策略。性能评估采用SCOPe40中的11,211个非冗余结构域,以及从AlphaFold蛋白质结构数据库中抽取的2000个全长蛋白质查询,将LoL-align与TM-align、Dali、Foldseek及其他结构比对方法进行比较,重点考察远缘同源识别灵敏度、残基级比对质量和计算时间。
结果
LoL-align通过概率评分与迭代锚点扩展实现高效结构比对
研究人员首先提出了一种不同于传统空间叠合的蛋白质结构比对策略。其核心思想是利用蛋白质内部残基之间的距离关系,判断两个蛋白质中的残基是否可能具有共同进化来源。
对于两个候选对应残基,LoL-align不仅考虑它们自身的局部结构特征,还将其分别与已经建立对应关系的锚点残基进行比较。如果两个蛋白质中相应残基与锚点之间的Cα距离相近,则说明该残基对更可能属于同源结构区域。
研究人员将这种结构一致性转换为LoL-score。该评分主要基于20 Å范围内的残基距离及序列间隔,能够识别具有相似局部空间关系的残基对,而不需要首先将两条蛋白质链严格叠合到同一坐标系。算法首先利用3Di结构信息和氨基酸替换评分进行初始概率比对,从中选出10个具有较高后验概率的七残基候选片段,再保留评分最高的3个作为初始锚点。
随后,LoL-align依次计算当前锚点对应的结构评分矩阵,并通过Forward–Backward算法重新估计所有候选残基对的后验对齐概率。满足概率阈值的新残基被加入锚点集合,进而为下一轮计算提供更多结构约束。这一过程持续迭代,使比对区域从少量高置信度片段逐步扩展至更完整的蛋白质结构。由于新增锚点会提供额外的空间关系信息,算法能够在比对过程中不断修正和扩展残基对应关系。
对于完整多结构域蛋白质,研究人员还引入额外的3Di和氨基酸序列评分,使算法能够继续扩展到距离当前锚点较远的其他结构域,避免比对局限于单一局部区域。这种策略的重要优势在于,不同结构域之间即使发生相对旋转或平移,其内部的局部距离关系仍可能保持稳定,因此LoL-align能够比依赖整体刚性叠合的方法更好地适应部分蛋白质构象变化。
除了结构评分,研究人员还训练了一个轻量级神经网络,通过局部比对长度、结构相似性、接触关系及序列拓扑等特征估计真实同源概率。该模型能够进一步区分具有相似局部结构但缺乏进化同源关系的蛋白质。在计算实现方面,研究人员开发了基于SIMD的向量化Forward–Backward算法,通过并行处理多个动态规划单元提高运行速度。传统概率动态规划通常需要在对数空间运算,以避免数值溢出,但频繁的对数与指数计算会增加运行时间。LoL-align通过分块归一化及矩阵内存复用,在保持数值稳定性的同时减少高成本运算,形成适合现代CPU架构的高效概率结构比对流程。
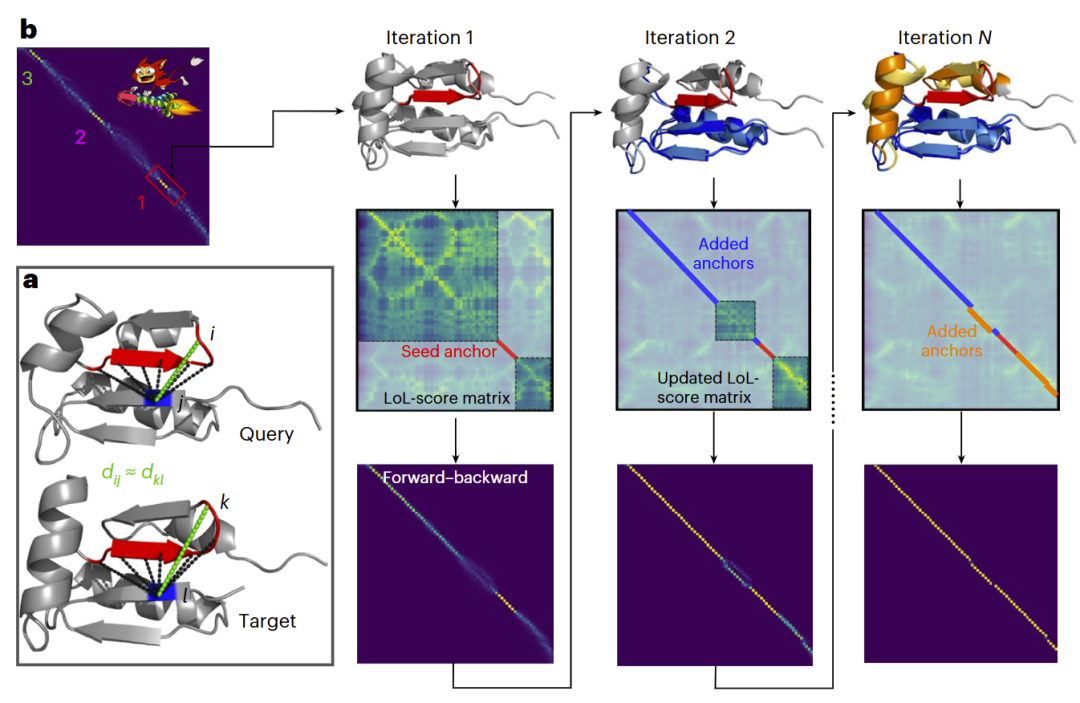
图1|LoL-align基于局部对数优势评分、概率动态规划与迭代锚点扩展的蛋白质结构比对流程。
LoL-align显著提高远缘同源蛋白质的识别灵敏度
为评估LoL-align在远缘同源识别中的表现,研究人员首先采用SCOPe40结构分类数据库进行系统测试。该数据集包含11,211个经过40%序列一致性聚类的非冗余蛋白质结构域。研究从中选择3,566个具有已知家族、超家族或折叠层级相关成员的结构作为查询对象,并将每个查询结构与整个数据库进行比对。
SCOPe通过家族、超家族和折叠层级描述蛋白质之间不同程度的结构及进化关系。其中,同一超家族中的蛋白质即使序列相似性较低,仍可能具有共同进化来源,因此是检验远缘同源识别能力的重要标准。
研究人员采用首次假阳性出现之前的灵敏度作为主要评价指标,即统计比对结果中,在第一次出现错误匹配之前能够正确识别多少已知同源蛋白质。该指标能够反映自动化结构搜索中控制假阳性的重要能力。
结果显示,在SCOPe超家族层级上,LoL-align的平均识别灵敏度比Dali提高7.3%,比TM-align提高9.9%,在不同查询结构中均表现出较为稳定的优势。进一步通过精确率–召回率曲线评估发现,LoL-align在超家族识别任务中的曲线下面积比Dali提高14.5%,比TM-align提高2.3%,说明该方法不仅能够找到更多远缘同源蛋白质,也能够较好地控制错误匹配。
研究人员还比较了家族、超家族和折叠三个不同分类层级的识别结果。总体而言,LoL-align在多个层级中均具有竞争优势,尤其在需要区分远缘同源与非同源结构的情况下表现突出。
为了使不同结构相似性评分能够用于实际搜索,研究人员进一步标定LoL-score与预测精确率之间的关系。例如,当评分阈值设置为0.65、0.60和0.50时,分别对应约99%、95%和75%的超家族识别精确率。这使LoL-align不仅能够为结构比对结果提供排序,还能够给出具有明确统计意义的置信度参考,为后续蛋白质功能注释和进化关系分析提供依据。
LoL-align改善全长多结构域蛋白质的比对质量
单结构域蛋白质的结构比对虽然适合评价远缘同源识别,但真实蛋白质往往由多个结构域组成,不同结构域之间还可能存在明显的构象变化。研究人员因此进一步采用完整蛋白质结构评估LoL-align的泛化能力。
研究从包含约230万个代表性预测结构的AlphaFold数据库中抽取2000个全长蛋白质作为查询对象,并要求每个查询蛋白质至少包含100个具有较高预测置信度的残基。
首先利用Foldseek进行快速搜索,为每个查询蛋白质保留最多2000个候选匹配,再使用LoL-align、TM-align、Dali和Foldseek分别对这些候选结构进行重新比对。由于该数据集缺乏完整的人工同源分类标签,研究人员采用基于LDDT的残基级结构一致性评价指标,分别衡量比对精确率和灵敏度,并通过两者的几何平均值G-score评价整体比对质量。
这一评价方式不依赖蛋白质的全局空间叠合,而是通过保守残基之间的局部距离一致性判断比对质量,因此更加适合包含多个结构域或发生构象变化的全长蛋白质。结果显示,LoL-align在全长蛋白质测试中仍然具有明显优势,其远缘同源搜索灵敏度显著高于Dali和TM-align,并且能够在大多数查询任务中获得更高的残基级比对质量。
值得注意的是,不同方法在精确率与灵敏度之间表现出不同偏好。Dali及基于同源概率的LoL-align评分倾向于保留高置信度局部对应关系,而TM-align和原始LoL-align评分则更重视覆盖较广的整体结构相似性。
研究人员通过改变精确率和灵敏度的相对权重,进一步分析不同方法的性能变化。结果发现,LoL-align在多种权重设置下均具有良好表现,说明其优势并不完全依赖某一种特定的评价方式。进一步将所有比对结果按照统一的G-score重新排序后,LoL-align仍能够获得更高的累计比对质量。这说明其性能提升不仅来自评分排序更加合理,也与生成的残基对应关系本身更加准确有关。
此外,研究人员还在包含低置信度结构区域的蛋白质数据上进行补充测试,发现LoL-align仍保持相似的性能优势,显示出对部分预测结构误差的适应能力。这些结果证明,LoL-align能够有效处理完整蛋白质中复杂的局部结构对应关系,尤其适合大规模预测结构数据库中的多结构域比对任务。
LoL-align在保持高精度的同时显著降低计算成本
对于包含数百万乃至数亿个预测结构的蛋白质数据库,仅提高比对灵敏度并不足以满足实际应用需求,计算速度同样决定算法能否用于大规模分析。
研究人员因此在全长蛋白质基准测试中比较不同方法的总体运行时间。所有程序均在具有128个物理CPU核心的计算系统上运行,并尽可能采用相同的并行计算条件。结果显示,在2000个查询蛋白质的结构比对任务中,LoL-align的运行速度约为TM-align的5倍、Dali的20倍,同时保持更高的远缘同源识别灵敏度和残基级比对质量。
这种效率提升主要来自对概率动态规划算法的重新实现。研究人员通过SIMD向量化同时处理多个计算单元,并利用分块归一化避免传统概率运算中频繁的对数变换。此外,通过复用前向、后向和后验概率计算所需的动态规划矩阵,进一步减少了内存使用和数据传输成本。与直接对数据库中所有结构执行复杂比对不同,LoL-align还能够与Foldseek组成分层搜索流程。首先利用Foldseek快速筛选具有潜在相似性的候选蛋白质,再通过LoL-align对排名靠前的结构进行精细比对。
这一设计将Foldseek的大规模快速检索能力与LoL-align的高灵敏度比对能力结合起来,使研究人员能够在可接受的计算时间内分析规模庞大的预测蛋白质结构数据。
目前,LoL-align已经集成至Foldseek开源软件及在线服务器,用户可以直接选择相应比对模式,对Foldseek搜索得到的候选结构进行重新比对。
此外,该方法也能够用于Foldmason等多重蛋白质结构比对工具。研究人员发现,在相关流程中使用LoL-align替换传统TM-align能够进一步带来一定的比对质量改善。
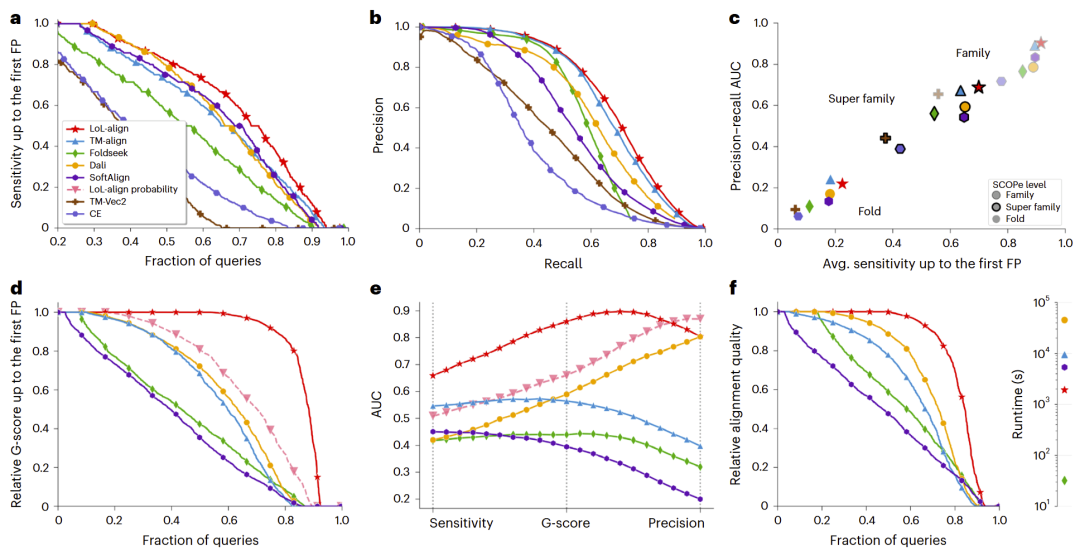
图2|LoL-align在单结构域远缘同源识别、全长蛋白质结构比对及计算效率方面的综合性能。
讨论
本研究提出的LoL-align为大规模蛋白质结构比较提供了一种兼顾识别灵敏度、比对准确性与计算速度的新方法。与依赖整体三维结构叠合的传统算法不同,LoL-align通过蛋白质内部原子距离关系和概率动态规划建立残基对应关系,因此能够更好地处理部分局部结构相似、结构域构象变化及远缘同源识别问题。
该研究的一个重要贡献是,将具有统计意义的局部对数优势评分与高效概率比对算法结合起来。研究人员不仅改进了结构相似性评价方式,还通过SIMD向量化、数值缩放和内存复用,使原本计算成本较高的Forward–Backward概率算法能够用于大规模蛋白质结构比对。
值得注意的是,LoL-align并未试图取代Foldseek的快速检索能力,而是将自身定位于候选结构的高精度比对阶段。这种先快速筛选、再精细比对的策略,能够充分利用不同算法的优势,也更加符合数亿规模蛋白质结构数据库的实际分析需求。
不过,LoL-align仍存在一定局限。其结构同源性判断依赖局部距离模式和训练数据所包含的结构关系,对于极端的结构重排、复杂拓扑变化或缺乏明显局部保守区域的蛋白质,仍可能受到影响。此外,结构相似性本身并不能完全证明进化同源关系,对于功能注释和进化推断,仍需结合序列信息、生物学背景及其他证据进行判断。
总体而言,LoL-align通过概率式局部结构评分和高效动态规划,在明显提高远缘同源识别灵敏度与残基级比对质量的同时,实现了较传统精细结构比对方法更高的计算效率。其与Foldseek的整合,为大规模蛋白质结构数据库中的功能注释、结构分类和进化关系研究提供了实用工具。
整理 | DrugOne团队
参考资料
Reifenrath, L., van Kempen, M., Kim, G. et al. LoL-align: sensitive and fast probabilistic protein structure alignment. Nat Methods (2026).
https://doi.org/10.1038/s41592-026-03249-w
内容为【DrugOne】公众号原创|转载请注明来源