因果推断研究因数据缺失失败,双重稳健与SuperLearner亦难补救
双重稳健+SuperLearner都上了,这项因果推断研究还是倒在了数据缺失上
摘要
2026年8月7日,医学论文与统计分析发布文章指出,一项采用双重稳健估计和SuperLearner等高级方法的因果推断研究,因数据缺失问题未能得出可靠结论。研究强调即使使用复杂统计技术,数据质量仍是因果推断的关键。该案例警示研究者需重视数据收集与缺失处理。
AI 主编 · 推荐理由推荐理由
对药企真实世界研究设计有警示意义:高级统计方法不能弥补数据缺失,注册和研发部门应加强数据管理,避免资源浪费。
五维评分
正文
源自风暴统计网:一键统计分析与绘图的网站
接下来让我们一起来看一下这篇文章!
研究设计与统计分析方法
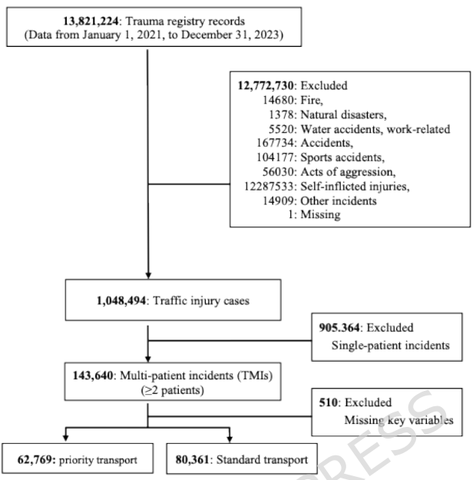
日本EMS体系规定,OHCA患者由独立的国家级专用数据库(Utstein模板)单独管理,因此本研究人群均为转运时存在生命体征的患者。 同时,研究未设置年龄下限,儿科患者(<18岁,占16.28%)完整纳入分析。
本研究的核心暴露为“优先转运”,定义为在同一事故中第一个从现场出发转运至医院的患者。
这一操作定义作为分诊优先级的实用代理指标,但作者明确承认,在复杂事故中转运顺序可能受后勤约束而非临床严重程度驱动,因此存在暴露测量误差的可能。
研究采用主动对照设计,将优先转运患者与非优先转运患者进行比较。
√结局定义
主要结局为医师评估的严重临床结局,定义为入院时医师评定的死亡、危重伤或重伤(复合结局)。
这一分类来源于FDMA注册登记系统的标准量表,由接诊医院主治医师在初次评估时评定。
患者从事故现场开始随访,结局在到达医院时评估。
协变量方面,研究纳入的基线变量包括年龄、性别、呼救时间和事故规模(2名患者 vs ≥3名患者)。
值得重点关注的是,现场时间未被纳入倾向性评分模型——作者将其视为暴露后变量而非基线混杂因素,这一方法学选择对结果解读有重要影响,后面我们会详细讨论。
√因果推断的核心策略:AIPW
本文主要使用增强逆概率加权(AIPW)完成因果推断,其思路是同时构建两个模型:
一个倾向性评分模型,预测患者接受优先转运的概率;
一个结局回归模型,预测患者出现严重结局的概率。
AIPW的“双重稳健”特性在于,只要这两个模型中任意一个被正确指定,就能给出无偏的效应估计。
这比单独依赖倾向性评分加权或单独依赖结局回归提供了更强的保障。
研究估计的目标参数为边际风险差(RD),即优先转运相对于非优先转运导致严重结局发生率的绝对差异。
√现场时间的效应修饰分析
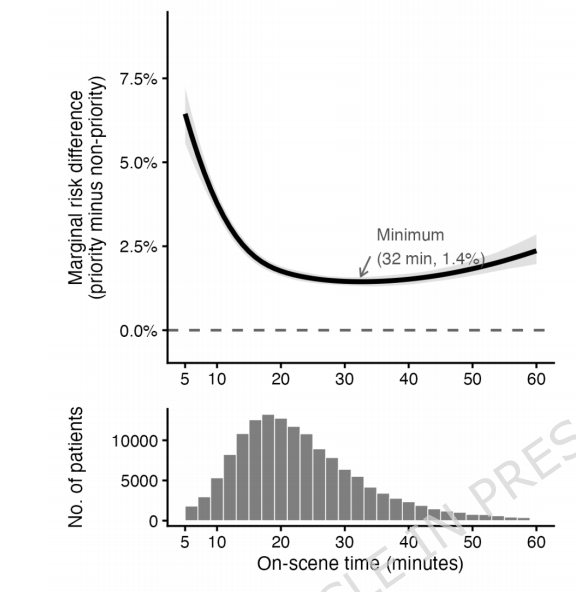
研究团队将现场时间视为效应修饰因子而非混杂因素,采用限制立方样条(RCS)对其建模,并在模型中纳入优先转运×现场时间的交互项。
随后,研究将每个患者的现场时间固定在5至60分钟间的每个整数值上,分别计算“所有人都接受优先转运”和“所有人都接受非优先转运”两种情境下的严重结局预测概率,
两者之差即为该现场时间点上的边际风险差。
由于现场时间是暴露后变量(可能本身受转运决策影响),这一曲线应当被理解为描述性效应异质性,而非改变现场时间带来的因果效应。
方差估计采用事故层面聚类Bootstrap(500次),以考虑同一事故内患者结局的相关性。
√敏感性分析
敏感性分析方面,研究开展了多组分析以验证主结果的稳健性:
重叠限制:将倾向性评分限制在0.1-0.9区间,排除极端评分的患者,验证结果是否由阳性性违背所驱动;
E-value计算:量化未测量混杂需要多强才能完全解释观察到的关联;
TMLE + SuperLearner验证:采用靶向最大似然估计(TMLE)结合SuperLearner集成学习作为补充分析方法,在模型设定和算法选择两个层面检验AIPW结果的敏感性;
协变量函数形式替换:对年龄、呼救时间的样条参数、事故规模的分类方式进行多种备择设定;
伤情严重度代理变量调整:利用诊断代码构建院前伤情严重度代理指标,纳入模型观察估计值变化。
主要研究结果
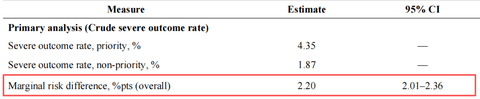
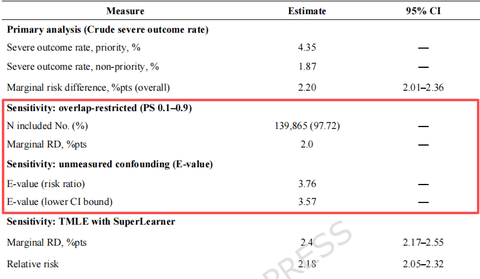
研究结果显示,优先转运组严重结局发生率为4.35%,非优先转运组为1.87%,在AIPW分析中,总体边际风险差为2.2个百分点(95% CI: 2.01-2.36)。
这意味着,在调整可测混杂后,优先转运患者的严重结局绝对风险比非优先转运患者高出约2.2个百分点。
同时,现场时间对上述关联存在显著的修饰作用(交互P < 0.001)。整个观察范围内风险差均为正值,呈现U形模式。
敏感性分析方面,TMLE+SuperLearner验证的边际风险差为2.4个百分点(95% CI: 2.17-2.55),与主结果高度一致。
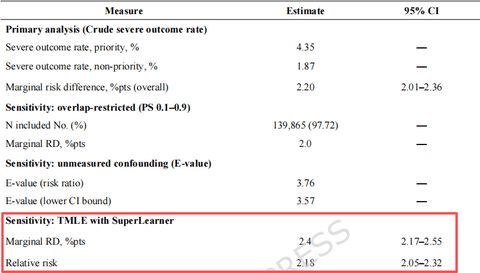
重叠限制分析中边际风险差为2.0个百分点,E-value为3.76(下限3.57)。
协变量函数形式替换与伤情严重度代理变量调整后,估计值亦无明显波动,共同支持了主结果的稳健性。
老郑小评
这篇文章在方法学上有三个值得关注的点--AIPW的双重稳健设计、现场时间的边际标准化处理、TMLE+SuperLearner的敏感性验证。
每一步都有明确的方法学理由,尤其是现场时间那块,把暴露后变量当效应修饰因子来用,回避了调整暴露后变量易引入碰撞分层偏倚的问题,思路很巧妙。
但方法再扎实,也绕不开数据本身的硬伤。
伤情严重度这个最关键的因素没测到。它既决定谁被优先转运,又决定谁预后更差。
AIPW只能调已测变量,调不了没测的。E-value=3.76虽然能说明需要多强的混杂才能解释掉结果,但不等于不存在这样的混杂。
临床上伤情严重度达到这个强度,完全可能。
关于郑老师团队及公众号
全国较大的医学统计服务平台,专注于医学生、医护工作者学术研究统计支持
郑老师团队可以提供诸多统计支持:
详情联系助教小董咨询(微信号aq566665)